跟着这篇走完,你会在自己电脑上跑起一个纯本地的中文语义检索服务:把一批中文文档写进 Chroma,然后 curl 调它的 REST API 问“数据库查询慢怎么办”,它能按意思找出最相关的那条,而不是靠关键词碰运气。整个过程 7 步,每步都有一条命令能验证自己做对了没有。全程不接 LLM、不联网调 API(只有第一次下载嵌入模型要联网),数据全部落在本地磁盘。
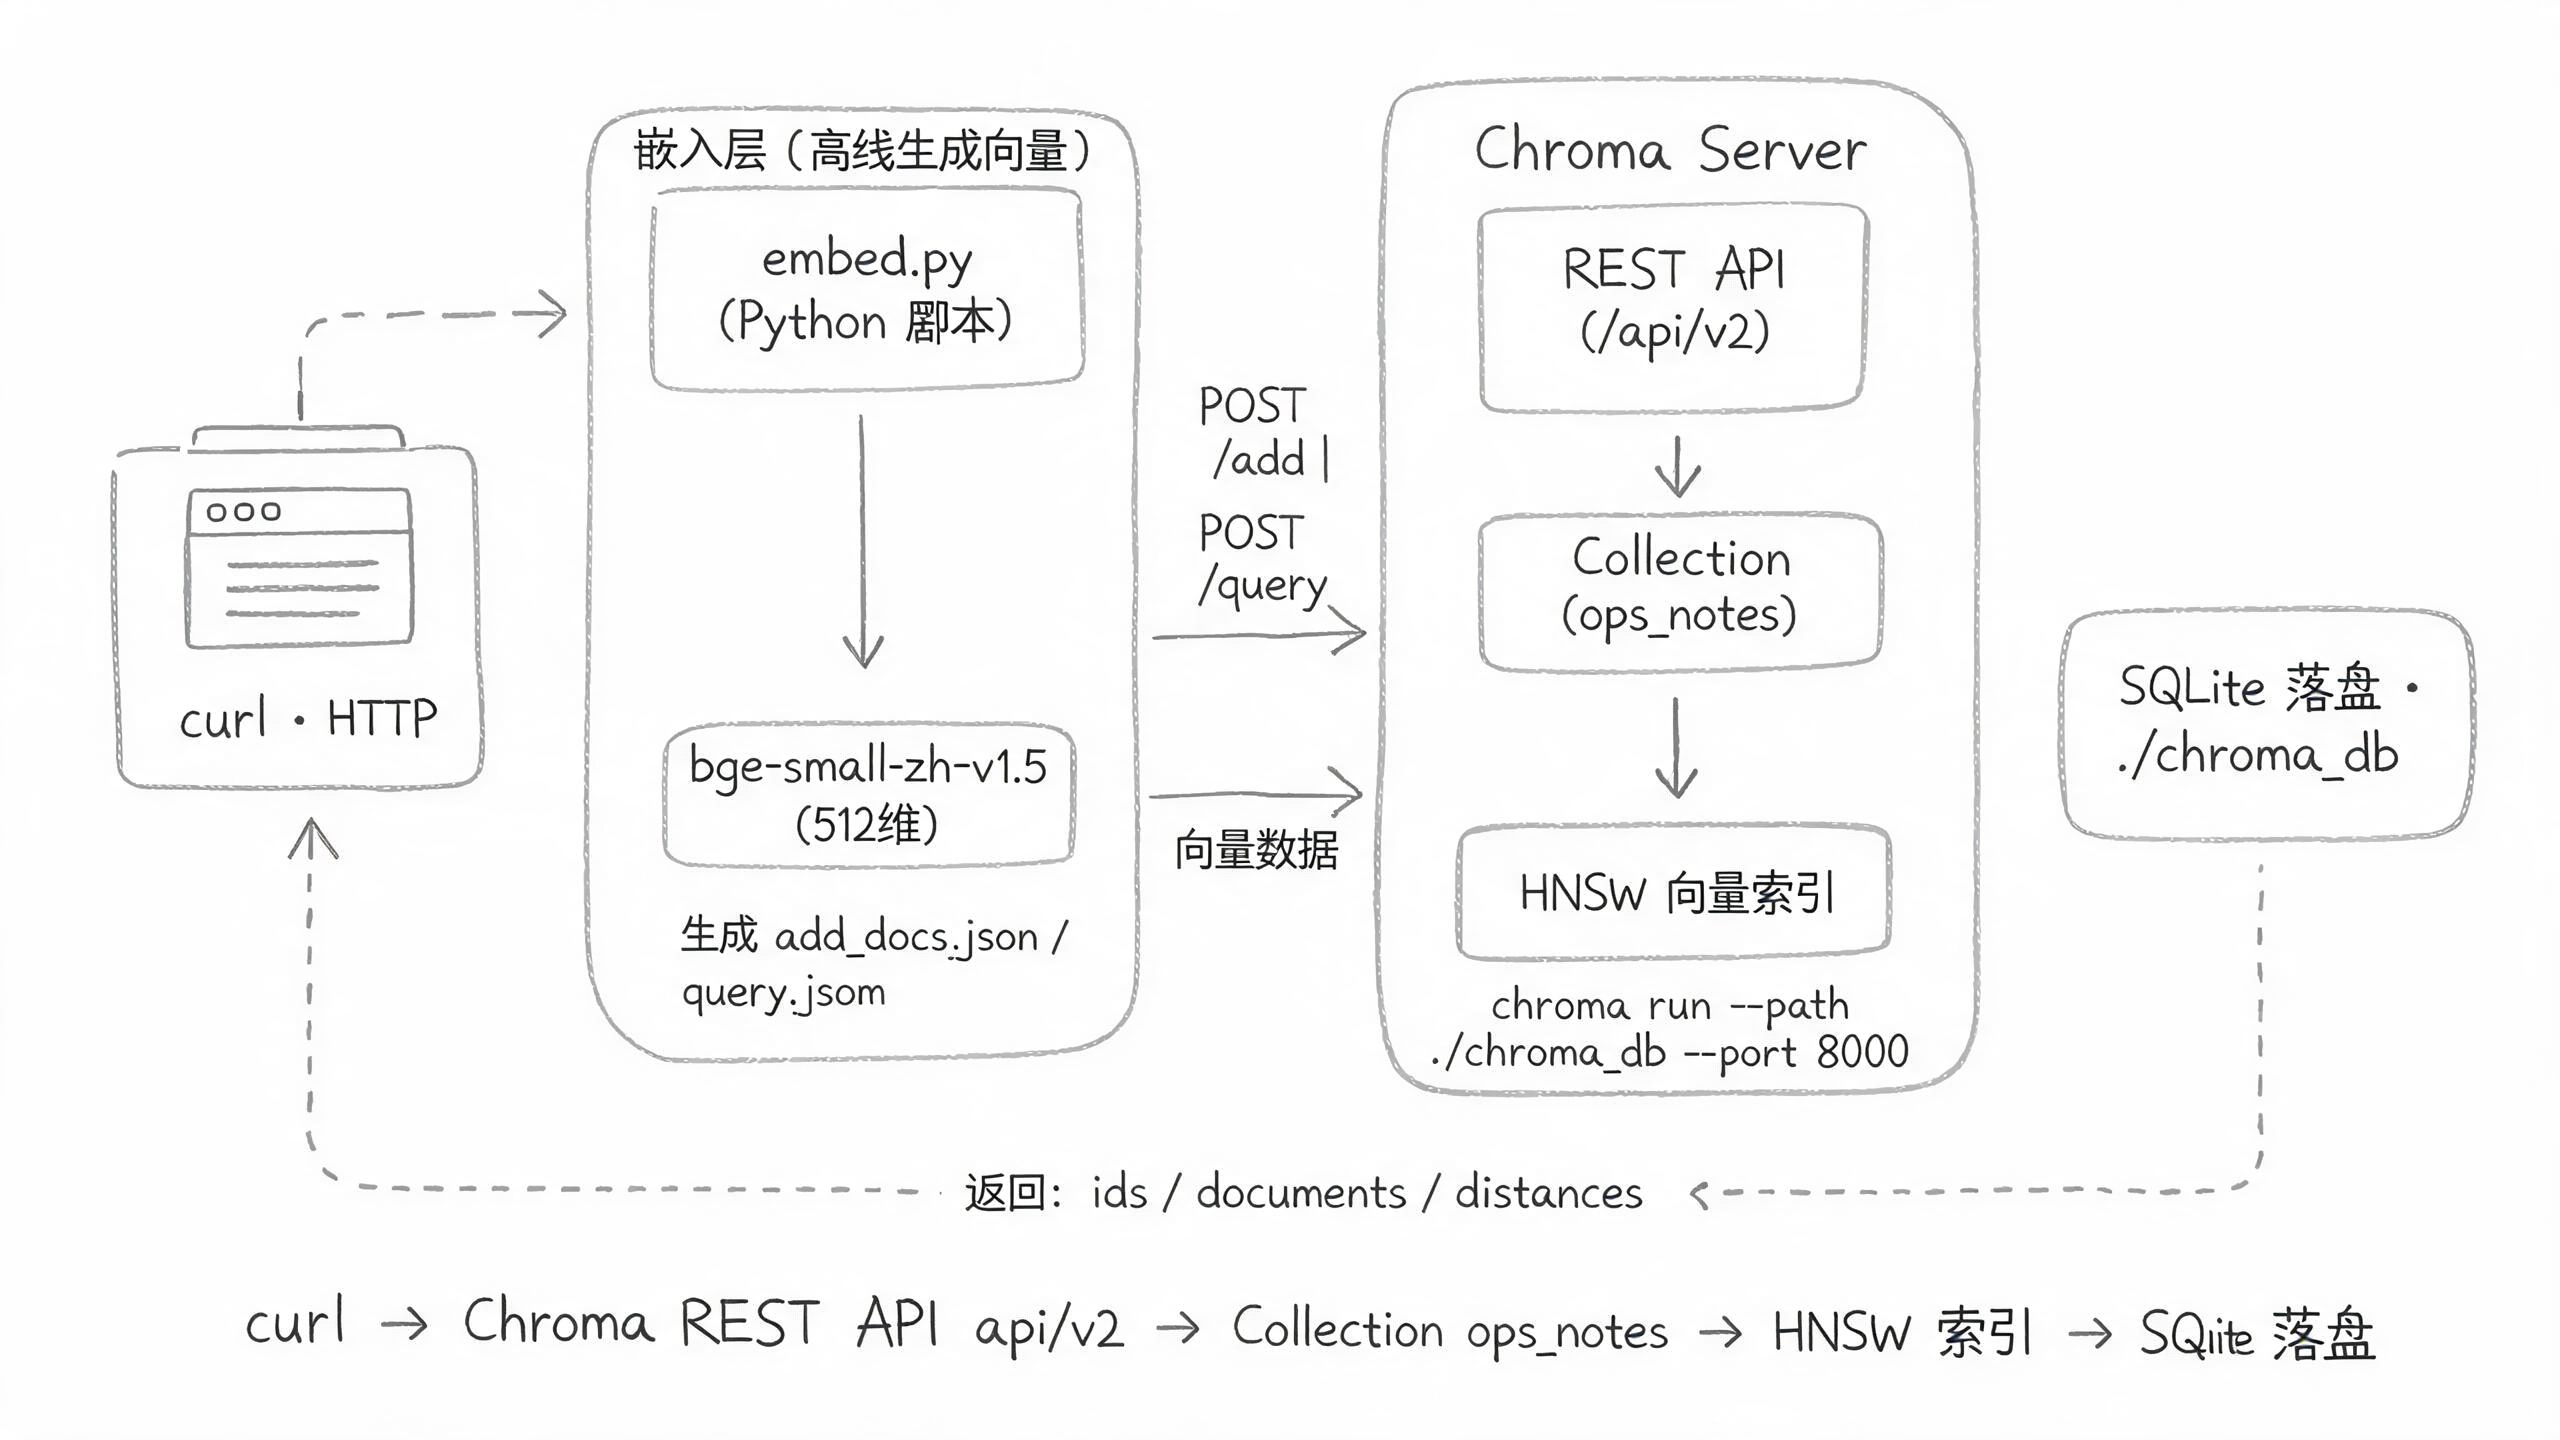
先说清这篇的玩法。Chroma 有两种用法:一是嵌在 Python 进程里(PersistentClient),二是起一个独立 server 进程,用 REST API 操作。本篇用第二种——你拿 curl 就能建库、写数据、查数据,请求体是标准 JSON,这套 API 换到任何语言都能直接调。一个关键区别要提前知道:server 模式不会自动帮你做嵌入(embedding),文档和查询的向量都得自己算好、随请求一起发给它。所以流程上多出“用 bge 模型生成向量文件”这一步,剩下的全是 curl。
动手前先交代环境。Python 固定用 3.12(实测环境 Python 3.12.5),嵌入模型固定用 BAAI/bge-small-zh-v1.5(智源研究院开源的轻量中文嵌入模型,512 维,约 92MB,CPU 就能跑);你要是换了 Python 版本或模型,把示例值替换掉即可。Windows/macOS/Linux 都能跑,但 Intel 芯片的 Mac 有一个版本锁定的坑,第二步会说清楚。
前置条件
| 项 | 要求 | 说明 |
|---|---|---|
| Python | 3.9 或更高(实测 3.12) | 装依赖、生成向量脚本用 |
| curl | 任意版本 | 全文用 curl 调 Chroma 的 REST API |
| 磁盘 | 约 2 GB 空闲 | 依赖 + 模型缓存约 1.5~2 GB |
| 网络 | 首次下载模型需能访问 HuggingFace 镜像 | 只这一次,之后完全离线;国内需设 HF_ENDPOINT(第三步讲) |
先跑这条,确认 Python 在不在、版本够不够。
python3 --version && pip3 --version看到 Python 3.12.x(或任何 3.9+)和 pip 2x.x 就满足条件。命令报 command not found 说明 Python 没装,先去官网装好再回来。
第一步:装 chromadb
先解释一下为什么第一步就是装库。Chroma 是一个“向量数据库”——它存的不是普通表格数据,而是向量(一串固定长度的数字,比如 512 个浮点数),检索方式是按向量距离找最近邻。pip install chromadb 会把这个数据库的完整实现装到你本地,里面自带一个 chroma 命令,第四步起 server 用的就是它;同时它也提供 Python 客户端,第三步生成向量要用。
python3 -m venv venv
source venv/bin/activate
pip install chromadb
第一行建一个独立的虚拟环境(venv),避免污染系统 Python;第二行激活它;第三行装库。装完顺手验证版本。
python -c "import chromadb; print(chromadb.__version__)"返回 1.5.9 就说明装好了(这是 2026-10 实测的稳定版,装到更新版本也正常)。pip install 卡住不动的话,多半是默认 PyPI 源太慢,换成阿里云镜像:pip install -i https://mirrors.aliyun.com/pypi/simple/ chromadb。清华镜像没同步 chromadb,别用。
第二步:装中文嵌入模型(sentence-transformers)
为什么这里要引入嵌入模型?Chroma 本身不会“理解”中文,而且 server 模式连嵌入都不会做——你要把文本变成向量,这个“把文本变成向量”的动作叫嵌入(embedding),得靠一个嵌入模型来做。Chroma 自带的默认嵌入模型是英文的(all-MiniLM-L6-v2),对中文效果很差。所以这一步装 sentence-transformers(一个让本地嵌入模型开箱即用的库),下一步用它加载中文模型 bge-small-zh-v1.5 批量生成向量。
pip install sentence-transformers装完验证能导入。
python -c "import sentence_transformers; print(sentence_transformers.__version__)"返回版本号(实测是 3.3.1)就装好了。这一步在 Intel 芯片的 Mac 上有个隐藏地雷:PyTorch 从 2.3.0 起不再为 Intel Mac 构建安装包,pip install sentence-transformers 会连带装 torch,直接装会失败或装出没法用的组合。遇到 Could not find a version that satisfies the requirement torch 之类的报错,先锁定 torch 再装:
pip install torch==2.2.2 sentence-transformers==3.3.1Apple Silicon(M 系列)和 Linux/Windows 用户不用管这条,最新版直接装即可。
第三步:用 bge 生成向量文件(server 不自动嵌入,向量得自己算)
上一步装好了“能跑嵌入模型的库”。这一步写一个小脚本,把 6 条中文文档和 2 个查询问题都转成 512 维向量,落成 JSON 文件。为什么不用 Python 客户端直接插数据?因为本篇走的是 REST API——server 只认向量,文本转向量这一步必须你自己完成。把向量先算好存成文件,后面两条 curl 直接 -d @file.json 把文件内容当请求体发出去,干净利落。
先建 embed.py:
import json
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-small-zh-v1.5", device="cpu")

docs = [
    "张伟提交了修复搜索接口超时的补丁",
    "系统在高峰期出现内存溢出的错误",
    "李娜整理了本周的会议纪要和行动项",
    "数据库连接池配置导致查询变慢",
    "王强在部署时遇到权限不足的问题",
    "日志文件占满了磁盘空间,需要清理",
]
authors = ["zhang", "li", "li", "wang", "wang", "zhao"]

# 文档向量:这是第五步 POST /add 的请求体
json.dump({
    "ids": [f"doc{i}" for i in range(len(docs))],
    "embeddings": model.encode(docs).tolist(),
    "documents": docs,
    "metadatas": [{"author": a} for a in authors],
}, open("add_docs.json", "w", encoding="utf-8"), ensure_ascii=False)

# 查询向量 1:第六步 POST /query 的请求体("数据库查询慢怎么办?")
json.dump({
    "query_embeddings": model.encode(["数据库查询慢怎么办?"]).tolist(),
    "n_results": 2,
    "include": ["documents", "distances"],
}, open("query.json", "w", encoding="utf-8"), ensure_ascii=False)

# 查询向量 2:第六步带 where 过滤的请求体("谁负责超时问题的修复?")
json.dump({
    "query_embeddings": model.encode(["谁负责超时问题的修复?"]).tolist(),
    "n_results": 3,
    "where": {"author": "zhang"},
    "include": ["documents", "distances"],
}, open("query_where.json", "w", encoding="utf-8"), ensure_ascii=False)

print("生成完毕: add_docs.json / query.json / query_where.json")
跑它。
python embed.py第一次运行会下载模型(约 92MB),下载完成后输出 生成完毕: add_docs.json / query.json / query_where.json。下载会卡住? bge-small-zh-v1.5 存在 HuggingFace 上,国内直连经常超时(报 ConnectionError / 长时间无进度)。解决:运行时加一个环境变量走镜像:
HF_ENDPOINT=https://hf-mirror.com python embed.py验证这一步——看 JSON 里到底有没有向量、是不是 512 维:
python -c "import json; d=json.load(open('add_docs.json')); print('条数:', len(d['ids']), '维度:', len(d['embeddings'][0]))"返回 条数: 6 维度: 512 就说明向量生成对了。add_docs.json 打开后是这样一组组“编号 + 512 个数字 + 原文 + 元数据”的结构,后面 curl 原样提交。
第四步:启动 Chroma server
向量备好了,现在把 Chroma 跑成一个独立的 HTTP 服务。chromadb 装完会带一个 chroma 命令行工具,run 子命令就是起 server。--path 参数别省:它指定数据落盘目录,重启后数据还在;不带的话数据写到当前目录下的 chroma/ 文件夹,换个目录启动就“丢库”(这个坑在常见问题第二条)。
chroma run --path ./chroma_db --port 8000命令会一直挂着(服务器本来就该常驻),光看终端没动还不够稳——新开一个终端 curl 心跳接口验证更靠谱:
curl http://localhost:8000/api/v2/heartbeat返回 "1.0.0"(一个 JSON 字符串,就是 server 的版本号)就说明服务活着。注意路径里是 /api/v2——Chroma 的新版 REST API 统一在 v2 名下;网上不少老教程写的 /api/v1 在新版本已经废弃,一调就报 Unimplemented,这也是一个常见的卡点(常见问题里会讲)。
第五步:curl 建 collection,写入 6 条文档
server 起来了,开始建库。collection 是 Chroma 里的数据集容器(类似关系数据库里的表),用 POST 创建。注意 REST API 的 URL 是层级式的:/api/v2/tenants/default_tenant/databases/default_database/collections,先租户(tenant)后数据库(database)再集合。
curl -X POST http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections \
  -H "Content-Type: application/json" \
  -d '{"name":"ops_notes"}'
{
"id": "20d9273c-12b6-409b-b452-1e1665823cee",
"name": "ops_notes",
"tenant": "default_tenant",
"database": "default_database"
}(实际返回里还有 configuration_json、schema 等一堆字段,上面按可读性精简了。)返回体里的 id 是一串 UUID。先把它复制下来存好——后面第五、六、七步的每条命令都要用它:Chroma 的 REST API 用 collection 的 id(不是名字)定位集合,下文所有 <collection_id> 占位符全部替换成这个 id。
collection 建好了,写入第三步生成的 6 条文档。请求体就是 add_docs.json 的内容(ids + embeddings + documents + metadatas 四样并排),curl 用 --data-binary @add_docs.json 直接把文件内容发出去:
curl -X POST http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections/<collection_id>/add \
  -H "Content-Type: application/json" \
  --data-binary @add_docs.json
返回 {} 就写进去了。验证文档数——GET count 接口:
curl http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections/<collection_id>/count返回 6 说明 6 条全部入库。这一步如果报 InvalidArgumentError,多半是 add_docs.json 里缺了 embeddings 或维度不对,回第三步重新生成一次即可。
第六步:curl 语义检索(这才是核心)
库里有 6 条数据了,这一步让它干活:输入一句自然语言,返回最相关的文档。这就是语义检索——它匹配的是“意思”而不是“关键词”。比如问“数据库查询慢怎么办?”,关键词层面跟“数据库连接池配置导致查询变慢”没有几个字重合,但语义上就是最相关的一条,这就是嵌入模型 + 向量距离的威力。
这一步只能回答“已经预编码过的问题”。
query.json里的查询向量是第三步用 bge 算死的 JSON 字面量,curl 只是把它发给 server。换个新问题(比如“部署报权限错”),需要先回 Python 跑model.encode(["部署报权限错"])把新向量算出来再发请求。这是 server 模式不自带嵌入的代价——生产里通常另起一个嵌入服务(比如 bge 的 HTTP 包装)专门算向量,主应用拿 curl 同时打两个服务。
查询走 POST /query,请求体里 query_embeddings 是问题的向量(第三步已算好),n_results 是要返回几条,include 指定返回哪些字段。直接提交 query.json:
curl -X POST http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections/<collection_id>/query \
  -H "Content-Type: application/json" \
  --data-binary @query.json
{
"ids": [["doc3", "doc5"]],
"documents": [["数据库连接池配置导致查询变慢", "日志文件占满了磁盘空间,需要清理"]],
"distances": [[0.41119486, 1.0792524]]
}这就是验证。期望输出看两点:
- 命中顺序:最相关的“数据库连接池配置导致查询变慢”排第一(它的 id 是
doc3)。 - 距离含义:
distances是距离,越小越相似(0 代表完全相同)。第一条 0.41、第二条 1.08,明显第一更接近。别把距离当相似度——相似度 = 1 - 距离(在 cosine 空间下),越大越相似。
再试一个带过滤的查询:REST API 的 /query 支持在请求体里加 where 字段做元数据过滤,比如“只看 author 是 zhang 的人里,谁负责超时问题的修复”。请求体已经备好在 query_where.json:
curl -X POST http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections/<collection_id>/query \
  -H "Content-Type: application/json" \
  --data-binary @query_where.json
{
"ids": [["doc0"]],
"documents": [["张伟提交了修复搜索接口超时的补丁"]],
"distances": [[0.88312197]],
"metadatas": [[{"author": "zhang"}]]
}where={"author":"zhang"} 只在 author 字段等于 zhang 的文档里检索,返回就只剩张伟那一条——注意“谁负责超时”跟“张伟”没有任何字面重合,模型知道它们相关,这就是语义检索。where 是向量检索和传统数据库过滤的结合,生产里常拿它做“只搜某个分类/某个租户”。
第七步:重启 server,验证数据还在
第六步把检索跑通了,但你可能还没意识到一件事:数据到底存哪了?前面 chroma run --path ./chroma_db 把数据落到了磁盘,这一步就把“重启不丢”的验证做扎实——这也是从“能跑”到“敢用”的分界线。
模拟一次真实重启:在跑着 server 的终端按 Ctrl+C 停掉进程,然后重新用同一个 --path 启动:
chroma run --path ./chroma_db --port 8000新开终端,验证文档数和检索还认不认得刚才的数据:
curl http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections/<collection_id>/count6curl -X POST http://localhost:8000/api/v2/tenants/default_tenant/databases/default_database/collections/<collection_id>/query \
-H "Content-Type: application/json" \
--data-binary @query.json{
"ids": [["doc3", "doc5"]],
"documents": [["数据库连接池配置导致查询变慢", "日志文件占满了磁盘空间,需要清理"]],
"distances": [[0.41119486, 1.0792524]]
}文档数还是 6、检索结果和第六步一模一样,持久化验证通过。注意这个 <collection_id> 跟第五步拿到的是同一个——collection id 在 server 重启后保持不变,重新跑 chroma run 不需要再 POST 一次建库。
到这里这个原型就走完了:把“已有文本 + 已有问题的向量”通过 curl 写进 Chroma 并检索,重启后数据还在。真正想用起来还差一步——加一个嵌入服务把“用户新问题”也自动转成向量。不想做这步,就保持这个“预先编码”形态当 demo;想真用,再起一个 bge 的 HTTP 包装服务。
核心概念
下面这张图是整条调用链路的走向,从左到右就是一次“写入”和一次“查询”的完整路径。
| 概念 | 是什么 | 类比 |
|---|---|---|
| 向量(embedding) | 把文本转成的一串数字(本文 512 维),语义相近的文本数字也相近 | 像把一句话压缩成一个“语义指纹”,意思像的指纹也像 |
| 向量数据库 | 存向量、按向量距离检索的数据库,Chroma 是其中一种 | 像专门为“按相似度找人”设计的数据库,而不是按 ID 查表 |
| collection | Chroma 里的数据集容器,类似关系数据库里的表 | 像一张表,但存的是一批向量 + 原文 |
| server 模式 | chroma run --path ... 起独立服务,数据落盘(SQLite),用 REST API 操作 |
像一个常驻的数据库进程,谁都能通过 HTTP 来读写 |
| REST API | Chroma server 的 HTTP 接口,统一在 /api/v2 路径下,请求体是标准 JSON |
像给数据库开了一扇门,curl、Python、Go 都能进来 |
| embedding | 文本 → 向量的转换过程,server 模式不会自动做,要自己算好随请求带上 | 像翻译官:入库和查询前,都得先把文本翻成数字 |
| HNSW 索引 | Chroma 底层用的近似最近邻算法,加快“找最相似向量”的速度 | 像图书馆的索引卡:不用一本本翻,按卡片直接找到相近的区域 |
| distance | 查询返回的距离值,越小越相似;不是相似度本身 | 像坐标距离:离得越近越相关 |
常见问题
InvalidDimensionException: Embedding dimension 512 does not match collection dimensionality 384
现象:collection 建好、写过数据后,换了个嵌入模型重新生成向量再写/再查,报维度不匹配。384 这个数字只是示例——任何“新模型维度 ≠ 老模型维度”的组合都会触发,本文用的是 512 维的 bge。
原因:collection 的维度在第一次写入时被锁定、之后不可改。换模型 = 换维度 = 报错。这是设计行为,不是 bug。REST 模式下同样适用:add_docs.json 里的向量维度必须和 collection 第一次写入时的维度一致。
重启 server 后 Collection not found,之前写的数据全没了
现象:chroma run --path ./chroma_db 启动 server、写入数据一切正常;停掉进程重新启动时,路径写成了 chroma_db(少了 ./),或者换了个目录再启动,curl 访问 collection 报找不到。
原因:数据落盘位置由 --path 决定,不同路径 = 不同库。./chroma_db 和 chroma_db 在某些终端里会被解析成同一个目录,但换工作目录、换绝对路径写法就立刻对不上;不带 --path 时数据写到启动时所在目录下的 chroma/,也是同样的坑。生产里把 --path 固定成一个绝对路径(或者环境变量)最稳。
相关文章:Chroma 用 Client() 建库,重启进程后 collection 全丢——这篇讲 Python Client() 内存模式的丢数据,根因不同但现象和排查思路相关,可对照看。
第一次运行卡在模型下载,或报 ConnectionError(huggingface.co 连不上)
现象:python embed.py 长时间无进度,或直接抛 ConnectionError: ... huggingface.co timed out(有的环境是 http:000)。
原因:bge 模型存在 HuggingFace,首次使用必须下载约 92MB,国内直连不通。设 HF_ENDPOINT=https://hf-mirror.com 走镜像即可。