跟着这篇走完,你会在终端把 Meilisearch 的排序跑通:用 sort 参数给搜索结果按评分、价格、日期排序,再把“新品优先”这类规则写进索引设置里常驻生效。整个过程 7 步,每步都有一条命令能验证自己做对了没有。
动手前先交代下环境。localhost:7700 是 Meilisearch 的默认监听地址,master key 固定用 aSampleMasterKey(与系列一致),索引(Meilisearch 的独立文档集合,相当于一张数据表)固定用 books_sort(本篇新建,不动前面的 books_zh),示例文档是 6 条虚构书籍;你要是换了端口、master key 或索引名,把示例值替换掉就行。这篇默认你已经装好并跑通了从零跑通 Meilisearch 本地搜索服务,还没跑起来先回去把服务起了再回来,安装、启动、异步任务轮询的套路全部复用第一篇。
前置条件
| 项 | 要求 | 说明 |
|---|---|---|
| Meilisearch | v1.54.3 或更高 | 与第一篇一致;本篇关键前提是版本 ≥ v1.36(默认规则拆成 attributeRank + wordPosition),太低照做会报错 |
| 前置文章 | 已跑通 meilisearch-local-search |
复用其安装/启动/master key/异步任务轮询套路;没跑通先回去补 |
| master key | aSampleMasterKey |
与系列一致 |
| curl | 任意版本 | 全文用 curl 调 REST API |
先跑这条,确认第一篇的服务还活着。
curl http://localhost:7700/health{"status":"available"}返回 {"status":"available"} 就满足条件。要是返回 curl: (7) Failed to connect to localhost port 7700,说明服务没起——回第一篇第一步用 meilisearch --master-key="aSampleMasterKey" 重新启动,再回来。
第一步:确认服务在跑、版本对不对
本篇大量依赖一个事实:v1.36 起 Meilisearch 把默认规则里的 attribute 拆成了 attributeRank 和 wordPosition,默认排名规则(rankingRules,决定搜索结果先后顺序的规则列表)从 6 条变成 7 条。后面写排名规则时要按新名单来,所以第一步先把版本确认掉,省得照老教程做了一路、最后在设置接口上报错。
curl http://localhost:7700/version -H "Authorization: Bearer aSampleMasterKey"{"commitSha":"7ebd97e38c36882b0c78d79e433b9115b4f003b3","commitDate":"2026-10-01T11:51:22.000000000+02:00","pkgVersion":"1.54.3"}版本号在 pkgVersion 字段里。验证标准就一条:版本 ≥ 1.36 就行。低于 1.36 的旧版默认规则不含 attributeRank/wordPosition,照本篇的命令做会踩到“找不到规则”之类的错,先升级再回来。
第二步:建 books_sort 索引 + 写 6 条书
排序要先有“可排序的字段”,而字段类型直接决定排对排错。这一步把数据底座搭好:rating、price 用 JSON 数字,release_date 用 YYYY-MM-DD 格式的字符串——数字按数值比大小,日期按字符串词典序比,这是后面所有步骤的前提。用独立索引 books_sort,不动第一篇的 books_zh。
索引走显式创建,直接指定主键字段为 id,避免自动推断失败:
curl -X POST http://localhost:7700/indexes \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"uid":"books_sort","primaryKey":"id"}'
{
"taskUid": 7,
"indexUid": "books_sort",
"status": "enqueued",
"type": "indexCreation"
}创建索引是异步任务(task,后台执行的操作单元),返回体里的 taskUid 就是任务编号。全新环境任务号从 0 开始;要是你的环境已经跑过其他任务,以实际返回的 taskUid 为准。
接着写 6 条书:
curl -X POST http://localhost:7700/indexes/books_sort/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '[
    {"id": 1, "title": "三体", "author": "刘慈欣", "rating": 9.3, "price": 39.9, "release_date": "2008-01-01", "genres": ["科幻"]},
    {"id": 2, "title": "球状闪电", "author": "刘慈欣", "rating": 8.8, "price": 29.0, "release_date": "2004-06-01", "genres": ["科幻"]},
    {"id": 3, "title": "活着", "author": "余华", "rating": 9.1, "price": 35.0, "release_date": "1993-01-01", "genres": ["文学"]},
    {"id": 4, "title": "许三观卖血记", "author": "余华", "rating": 8.7, "price": 32.0, "release_date": "1995-03-01", "genres": ["文学"]},
    {"id": 5, "title": "明朝那些事儿", "author": "当年明月", "rating": 9.0, "price": 45.5, "release_date": "2006-09-01", "genres": ["历史"]},
    {"id": 6, "title": "万历十五年", "author": "黄仁宇", "rating": 8.9, "price": 28.0, "release_date": "1982-05-01", "genres": ["历史"]}
  ]'
{
"taskUid": 8,
"indexUid": "books_sort",
"status": "enqueued",
"type": "documentAdditionOrUpdate"
}文档添加同样是异步任务,POST 返回的 taskUid 只表示入队,文档还没被索引。等对应任务 succeeded 再往下走。
确认数据到位:
curl http://localhost:7700/indexes/books_sort/stats \
  -H "Authorization: Bearer aSampleMasterKey"
{
"numberOfDocuments": 6,
"isIndexing": false,
"fieldDistribution": {
"author": 6, "genres": 6, "id": 6, "price": 6,
"rating": 6, "release_date": 6, "title": 6
}
}返回里 numberOfDocuments 是 6、isIndexing 是 false,说明 6 条文档全部索引完。要是数量是 0 或 isIndexing 还是 true,多半是任务没等完就查,回第一篇把轮询套路捡起来,见Meilisearch 添加文档后立即搜索返回空结果。
第三步:先撞一次坑——不声明就传 sort
很多人以为排序属性跟在文档里、直接传 sort 就能排。这一步故意不声明任何东西就传 sort,让报错把“前置声明”这个核心约束讲明白:排序依赖为属性预建的内部数据结构,必须在设置里显式声明。
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"","sort":["rating:desc"]}'
{
"message": "Index `books_sort`: Attribute `rating` is not sortable. This index does not have configured sortable attributes.",
"code": "invalid_search_sort",
"type": "invalid_request",
"link": "https://docs.meilisearch.com/errors#invalid_search_sort"
}rating 明明在文档里,为什么不能排?因为 filter 有 filterableAttributes、sort 有 sortableAttributes,两套列表相互独立,默认都是空数组。排序靠的是索引阶段为属性建好的列式结构,不能在搜索请求里临时为任意字段排序——把高成本操作前置到索引阶段,是 filter/sort/facet 三者的统一设计。
顺带看一眼默认设置,把排名规则(rankingRules)的默认名单记下来,后面两步要用:
curl http://localhost:7700/indexes/books_sort/settings \
  -H "Authorization: Bearer aSampleMasterKey"
{
"rankingRules": ["words", "typo", "proximity", "attributeRank", "sort", "wordPosition", "exactness"],
"sortableAttributes": [],
"filterableAttributes": []
}验证就两条:上面请求的返回码是 invalid_search_sort(不是 200);settings 里 sortableAttributes 是 []。要是你看到的是 Attribute "xx" is not filterable 那类报错,说明把 sort 和 filter 的声明搞混了,排查入口见Meilisearch sort 属性未声明报 invalid_search_sort。
第四步:声明 sortableAttributes
第三步的报错说明缺前置声明,这一步补上。把三个要排的字段一次性放进 sortableAttributes(允许参与排序的属性白名单):
curl -X PUT http://localhost:7700/indexes/books_sort/settings/sortable-attributes \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '["rating","price","release_date"]'
{
"taskUid": 9,
"indexUid": "books_sort",
"status": "enqueued",
"type": "settingsUpdate"
}这一步有个容易忽略的点:设置更新也是异步任务(type 为 settingsUpdate),还会重索引该索引的全部数据。任务没 succeeded 就发带 sort 的搜索,照样报 not sortable——配置已经写进去了,但旧索引还没重建完。
验证一下:
curl http://localhost:7700/indexes/books_sort/settings/sortable-attributes \
-H "Authorization: Bearer aSampleMasterKey"["price", "rating", "release_date"]返回三个属性就成。注意返回顺序是字母序(price/rating/release_date),跟你提交的顺序无关,别拿这个当报错。等不到 succeeded 就搜仍会报 not sortable,见Meilisearch 添加文档后立即搜索返回空结果。
第五步:sort 参数排序
前置声明到位,正式用 sort 参数。它写在搜索请求 body 里,格式是数组,每项 属性:方向(asc 升序 / desc 降序),数组顺序即优先级。先跑单字段:空查询(q 为空,官方叫 placeholder search——不搜关键词、拿全量列表)加排序,就是“榜单/全量列表”场景:
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"","sort":["rating:desc"]}'
hits 顺序(rating 降序):
三体 9.3 → 活着 9.1 → 明朝那些事儿 9.0 → 万历十五年 8.9 → 球状闪电 8.8 → 许三观卖血记 8.7再传第二个字段做 tiebreaker(打平时用的决胜规则)。前面规则分出胜负就不再往后看,同 rating 的两本才用 price:asc 决定先后:
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"","sort":["rating:desc","price:asc"]}'
hits 顺序(rating 降序,同分按 price 升序):
三体 9.3/39.9 → 活着 9.1/35.0 → 明朝那些事儿 9.0/45.5 → 万历十五年 8.9/28.0 → 球状闪电 8.8/29.0 → 许三观卖血记 8.7/32.0这两个数据集的 rating 没有同分,看不出 tiebreaker 在动。再补一条查询词 + 排序组合的验证,确认排序在文本查询下也生效:
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"刘慈欣","sort":["rating:desc"]}'
{
"hits": [
{"id": 1, "title": "三体", "author": "刘慈欣", "rating": 9.3},
{"id": 2, "title": "球状闪电", "author": "刘慈欣", "rating": 8.8}
],
"estimatedTotalHits": 2
}期望输出:三组结果顺序与上面一致——q=刘慈欣 命中两本,三体 9.3 排在球状闪电 8.8 前。要是带了 sort 返回 400 invalid_search_sort,多半是第四步没等完或属性名拼错,见Meilisearch sort 属性未声明报 invalid_search_sort。
第六步:自定义排名规则(release_date:desc)
sort 参数有个局限:每次请求都得传,只对本次生效。而“新品优先”“评分优先”这类是常驻业务规则——产品上希望不传任何参数、每次搜索都按它排。这一步把规则写进索引设置,用自定义排名规则(custom ranking rule)。
语法跟 sort 参数一样是 属性:方向,放进排名规则链(rankingRules)末尾。注意这里必须把默认 7 条全带上:PUT /settings/ranking-rules 是全量覆盖语义,只传新规则会把 words/exactness 全冲掉,相关度排序直接失效。
curl -X PUT http://localhost:7700/indexes/books_sort/settings/ranking-rules \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '["words","typo","proximity","attributeRank","sort","wordPosition","exactness","release_date:desc"]'
{
"taskUid": 10,
"indexUid": "books_sort",
"status": "enqueued",
"type": "settingsUpdate"
}设置更新同样要等 succeeded,并触发全量重建。
验证常驻生效——不传 sort 参数,直接搜:
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"刘慈欣"}'
{
"hits": [
{"id": 1, "title": "三体", "author": "刘慈欣", "release_date": "2008-01-01"},
{"id": 2, "title": "球状闪电", "author": "刘慈欣", "release_date": "2004-06-01"}
],
"estimatedTotalHits": 2
}release_date:desc 是链尾规则,作为 tiebreaker 生效:文本相关度先裁决,打平时新书靠前。三体(2008)排到球状闪电(2004)前。要是 PUT 返回 400,检查语法——旧版函数式写法 desc(release_date) 自 v0.22 起废弃,见Meilisearch 自定义排名规则旧语法报 invalid_settings_ranking_rules。
第七步(进阶):规则链位置的影响
自定义规则放链尾是“软排序”,放链首就变成“硬排序”——排名规则从第一条开始裁决,越靠前权重越大。先跑一次基线,记住当前配置(release_date:desc 在链尾)下 q=三 的顺序:
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"三"}'
{
"hits": [
{"id": 1, "title": "三体", "rating": 9.3},
{"id": 4, "title": "许三观卖血记", "rating": 8.7}
],
"estimatedTotalHits": 2
}三体(9.3)在前、许三观卖血记(8.7)在后。现在把 rating:asc 挪到链首,让评分成为第一裁决规则:
curl -X PUT http://localhost:7700/indexes/books_sort/settings/ranking-rules \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '["rating:asc","words","typo","proximity","attributeRank","sort","wordPosition","exactness"]'
{
"taskUid": 11,
"indexUid": "books_sort",
"status": "enqueued",
"type": "settingsUpdate"
}等任务 succeeded,再搜同一个 q=三:
curl -X POST http://localhost:7700/indexes/books_sort/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"三"}'
{
"hits": [
{"id": 4, "title": "许三观卖血记", "rating": 8.7},
{"id": 1, "title": "三体", "rating": 9.3}
],
"estimatedTotalHits": 2
}顺序整个翻转:评分 8.7 的许三观卖血记排到 9.3 的三体前。这就是位置即权重——规则越靠前越贴业务排序、越牺牲相关度。规则链从第一条开始裁决,rating:asc 放链首意味着先按评分升序硬排,words 那套相关度规则只在评分平局时才轮到。
验证完收尾,把排名规则恢复默认,别污染后面系列文章的实验环境:
curl -X DELETE http://localhost:7700/indexes/books_sort/settings/ranking-rules \
  -H "Authorization: Bearer aSampleMasterKey"
{
"taskUid": 12,
"indexUid": "books_sort",
"status": "enqueued",
"type": "settingsUpdate"
}等 succeeded 后 GET /settings,rankingRules 应回到默认 7 条。到这里排序与自定义排名就全跑通了。
核心概念
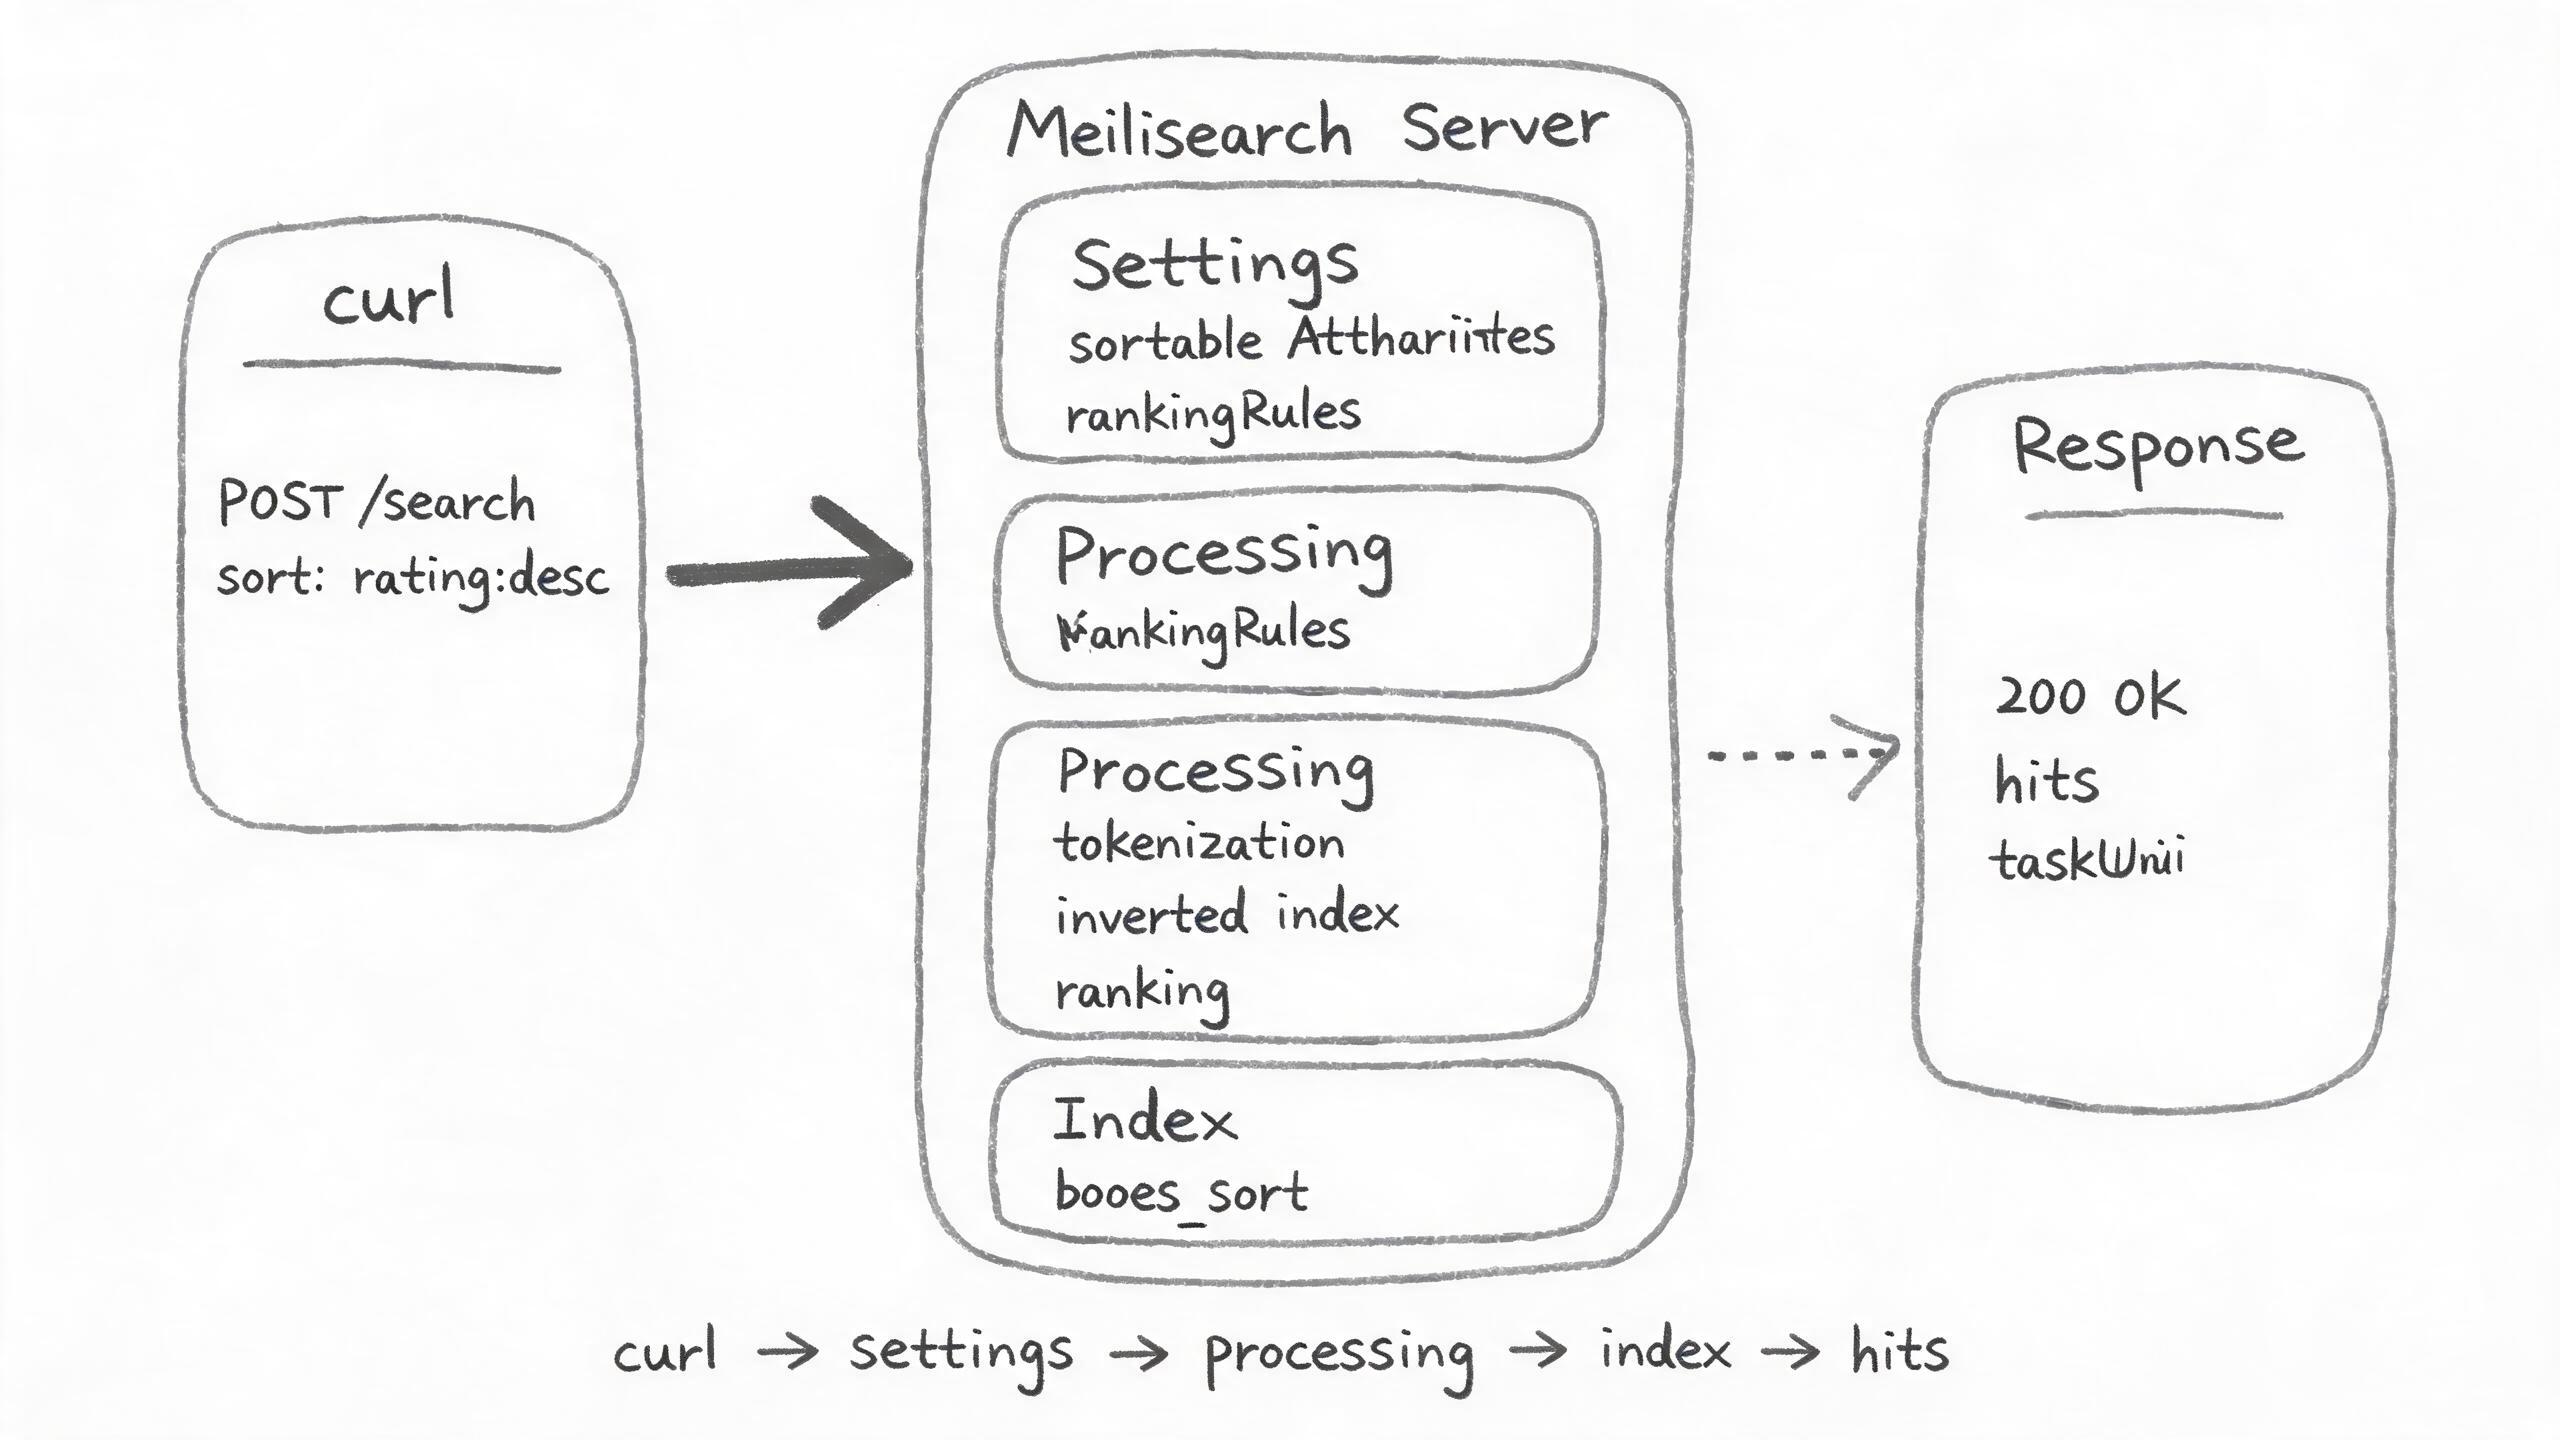
下面这张图是整条调用链路的走向,从左到右就是一次请求的完整路径。
| 概念 | 是什么 | 类比 |
|---|---|---|
| rankingRules(排名规则链) | 决定搜索结果先后顺序的规则列表,从头到尾一条条裁决,排前面的规则权重更大 | 像考试阅卷顺序:先看总分定名次,同分再看单科 |
| sortableAttributes | 声明“允许参与排序”的属性列表,不声明就无法用 sort | 像 SQL 里 ORDER BY 的字段白名单 |
| sort 参数 | 搜索请求里临时传的排序条件,如 ["rating:desc"],只对本次请求生效 |
像在结果页临时点一次“按价格排序” |
| 自定义排名规则 | 写死在索引设置里的常驻排序规则(release_date:desc),不传 sort 也生效 |
像平台预置的“新品优先”排序,用户不用点 |
| tiebreaker | 前面规则打平时的“决胜规则”,多字段排序里第二个字段就是 tiebreaker | 像比赛同分时看净胜球 |
| 异步任务(task) | 设置/写入类操作后台执行,返回 taskUid,要轮询到 succeeded 才生效 | 像后台发货:下单先返回订单号,物流到了才算完 |
| 全量重建索引 | 设置变更后 Meilisearch 重算全部文档的内部索引,耗时与数据量成正比 | 像给大表加索引要重扫一遍数据 |
| placeholder search | 空查询(q 为空)的搜索,用来拿“全量列表 + 排序/分页” | 像不搜关键词直接翻商品总列表 |
常见问题
invalid_search_sort:属性没声明就传 sort
现象:搜索请求带 "sort":["rating:desc"] 返回 400,错误码 invalid_search_sort,rating 明明存在于文档里。
原因:排序属性未在 sortableAttributes 里声明。filter 用 filterableAttributes、sort 用 sortableAttributes,两套独立白名单,默认都是空数组。
invalid_settings_ranking_rules:设排名规则返回 400
现象:PUT /settings/ranking-rules 传 ["words",...,"desc(release_date)"] 返回 400,错误码 invalid_settings_ranking_rules。
原因:用了旧版函数式语法 asc()/desc(),自 v0.22 起废弃。现行写法是 属性:asc / 属性:desc,如 "release_date:desc"。
排序不生效:声明了 sortableAttributes 结果还是旧顺序
现象:PUT sortable-attributes 或 ranking-rules 后立即搜索,结果顺序没有任何变化,也不报错。
原因:设置更新是异步任务(settingsUpdate)且触发全量重建索引。任务还在 enqueued/processing 时搜索,用的仍是旧索引。轮询 GET /tasks/{taskUid} 到 status: succeeded 再搜。