
跟著這篇走完,本機就能把 DeepSeek-R1 跑起來。先用命令行跟它聊一輪熱熱手,再調 /api/chat 發請求,讓響應裡 message.thinking(推理思考過程)和 message.content(最終回答)分兩個字段給你。
整個流程 5 步,每步結尾都附一條 curl 或 ollama 命令驗證你這步有沒有走對。localhost:11434 是 Ollama 的預設監聽端口,模型本文固定用 deepseek-r1:8b(即 5.2 GB 的 Q4_K_M 蒸餾版,基座是 Qwen3-8B,和 deepseek-r1:latest 指向同一份權重)。
如果你換了端口,或者改用 1.5b / 14b / 32b / 70b 這些 tag,把示例值替換掉就行,整套命令照樣能跑。還沒裝過 Ollama 的,先去從零跑通 Ollama + Qwen3 本地對話把服務拉起來再回來。
前置條件
| 項 | 要求 | 說明 |
|---|---|---|
| Ollama | 0.34.4 或更高 | 0.40.0 仍是預發佈版,不要用 |
| 磁盤 | 6 GB 以上空閒 | deepseek-r1:8b 是 DeepSeek-R1-0528-Qwen3-8B 蒸餾版,Q4_K_M 量化 5.2 GB |
| 記憶體 | 16 GB 以上(8b 推理)/ 32 GB+(14b)/ 64 GB+(32b)/ 96 GB+(70b) | 8B 加載後常駐約 5 GB;大模型按 tag 推 |
| 網絡 | 能訪問 ollama.com | 首次拉模型需下載 5.2 GB,之後可完全離線 |
先跑這條確認版本。
ollama --version看到 ollama version is 0.34.4 就滿足條件。命令報 command not found 說明 Ollama 沒裝成功,先解決再往下走。
第一步:安裝並啟動 Ollama
macOS 和 Linux 用同一條安裝腳本,Windows 用 PowerShell。不想跑腳本的話,去官方下載頁拿各平臺的圖形安裝包。
# macOS / Linux
curl -fsSL https://ollama.com/install.sh | sh
# Windows(PowerShell)
irm https://ollama.com/install.ps1 | iex裝完之後 macOS 和 Windows 上 Ollama 會常駐選單欄並自動拉起服務,Linux 上安裝腳本會註冊 systemd 服務並立即啟動。這一步不用你手動跑 ollama serve,除非你跑在 Docker 或純命令行環境裡,那才需要自己起進程。
驗證服務在監聽預設端口。
curl http://localhost:11434/api/version返回 {"version":"0.34.4"} 說明服務在跑,可以進入下一步。返回 curl: (7) Failed to connect to localhost port 11434 是服務沒起 / OLLAMA_HOST 被改到別的地址 / 容器內 localhost 指自己,看 常見問題 第 1 項。
第二步:拉 deepseek-r1:8b
Ollama 的模型不會隨安裝包一起下發,要單獨 pull 到本地。deepseek-r1 是倉庫名,8b 是規格 tag,寫全了才能避開歧義。
ollama pull deepseek-r1:8b下載 5.2 GB,速度看網絡。deepseek-r1 是倉庫名,8b 是規格 tag——寫全了才能避開歧義。
這裡的 8b 實際是 DeepSeek-R1-0528-Qwen3-8B(arch=qwen3、parameters=8.19B、Q4_K_M 量化、128K 上下文),跟 deepseek-r1:latest 指向同一份 blob。
deepseek-r1 倉庫下還有更小和更大的規格,按機器記憶體挑一檔:
| tag | 磁盤 | 上下文 | 適合 |
|---|---|---|---|
deepseek-r1:1.5b |
1.1 GB | 128K | 只驗證鏈路 |
deepseek-r1:8b |
5.2 GB | 128K | 本文用 |
deepseek-r1:14b |
9.0 GB | 128K | 32 GB 記憶體 |
deepseek-r1:32b |
20 GB | 128K | 64 GB 記憶體 |
deepseek-r1:70b |
43 GB | 128K | 96 GB+ 記憶體 |
驗證模型是否真的落到本地。
ollama list輸出裡出現一行 deepseek-r1:8b、SIZE 列顯示 5.2 GB,就算拉好了。列表裡沒它,說明前面的 pull 中途失敗。報 Error: pull model manifest: file does not exist 一般是 tag 寫錯或大小寫錯(比如 deepseek-r1:8B),看 常見問題 第 2 項。
第三步:用命令行完成一次 thinking 會話
ollama run 會拉起模型並進入交互提示符,這是最快確認「模型到底能不能答」的方式。
ollama run deepseek-r1:8b首次執行要把權重加載進記憶體,會等幾秒到幾十秒——第一次跑這種規模模型基本都有這一步等加載的耐心挑戰,別誤以為進程卡死了。加載完出現 >>> 提示符,直接敲問題回車即可。
DeepSeek-R1 跟一般聊天模型不一樣:會先輸出 thinking(推理過程),再輸出 content(正式回答)。CLI 預設就開著 thinking,不用額外開關。
在 >>> 下輸入:
>>> 用一句话解释什么是栈溢出
>>> /bye
能看到先出一段 thinking 再給最終答案;/bye 乾淨退出回到 shell,這一步就算成了。如果進程被 kill 或報 Error: model requires more system memory,多半是上一個模型還在 keep-alive 緩存裡沒釋放,看 常見問題 第 3 項。
第四步:用 REST API 發一次帶 thinking 的請求
Ollama 服務同時暴露了一套 HTTP 接口,端口就是剛才驗證過的 11434。先發一條單輪請求確認接口通,同時驗證 think 參數能讓響應裡出現 message.thinking 字段。
curl http://localhost:11434/api/chat -d '{
  "model": "deepseek-r1:8b",
  "messages": [
    { "role": "user", "content": "用一句话说明 /api/chat 的 stream 和 think 参数区别" }
  ],
  "think": true,
  "stream": false
}'
think: true 顯式開啟思考輸出(預設值其實就是 true,寫出來主要為了明確);stream: false 一次性拿完整 JSON,便於對照字段。
注意一個容易踩的點:Ollama 響應裡用 message.thinking 裝思考過程,用 message.content 裝最終回答——這跟 DeepSeek 雲 API 的 message.reasoning_content 不是同一個字段,把雲 SDK 搬過來直接讀 reasoning_content 會拿到 undefined。
返回體同時滿足四條就算通了:"done": true、message.thinking 非空、message.content 非空、eval_count > 0。
eval_count 是這次實際生成的 token 數——它為 0 就說明模型啥都沒吐出來,多半是模型名寫錯或者顯存不夠加載失敗。
message.thinking 是空或字段缺失,那基本是按 DeepSeek 雲 SDK 在 message.reasoning_content 取值、拿到 undefined 的問題了,看 常見問題 第 4 項。
第五步(可選進階):流式看 thinking 實時迴流
把 stream 打開,給 curl 加 -N 關掉輸出緩衝,讓 /api/chat 一邊生成一邊返回。
curl -N http://localhost:11434/api/chat -d '{
  "model": "deepseek-r1:8b",
  "messages": [
    { "role": "user", "content": "从 1 数到 5" }
  ],
  "think": true,
  "stream": true
}'
流式響應裡 message.thinking 增量分片出現在 message.content 之前——這是肉眼能看到“思考過程一個字一個字地往外冒”的唯一方式。done: true 只在最後一行出現,前面每一行都是中間分片。
關掉 thinking 有幾種寫法,按你的場景挑:
- 請求體裡把
think改成false,或者乾脆不寫——簡單粗暴。 - 會話內
/set notthink,CLI 預設開啟 thinking,臨時切到notthink。 - CLI 啟動時加
--hidethinking,適合腳本里想隱藏思考過程、但仍允許模型內部推理的場景。
核心概念
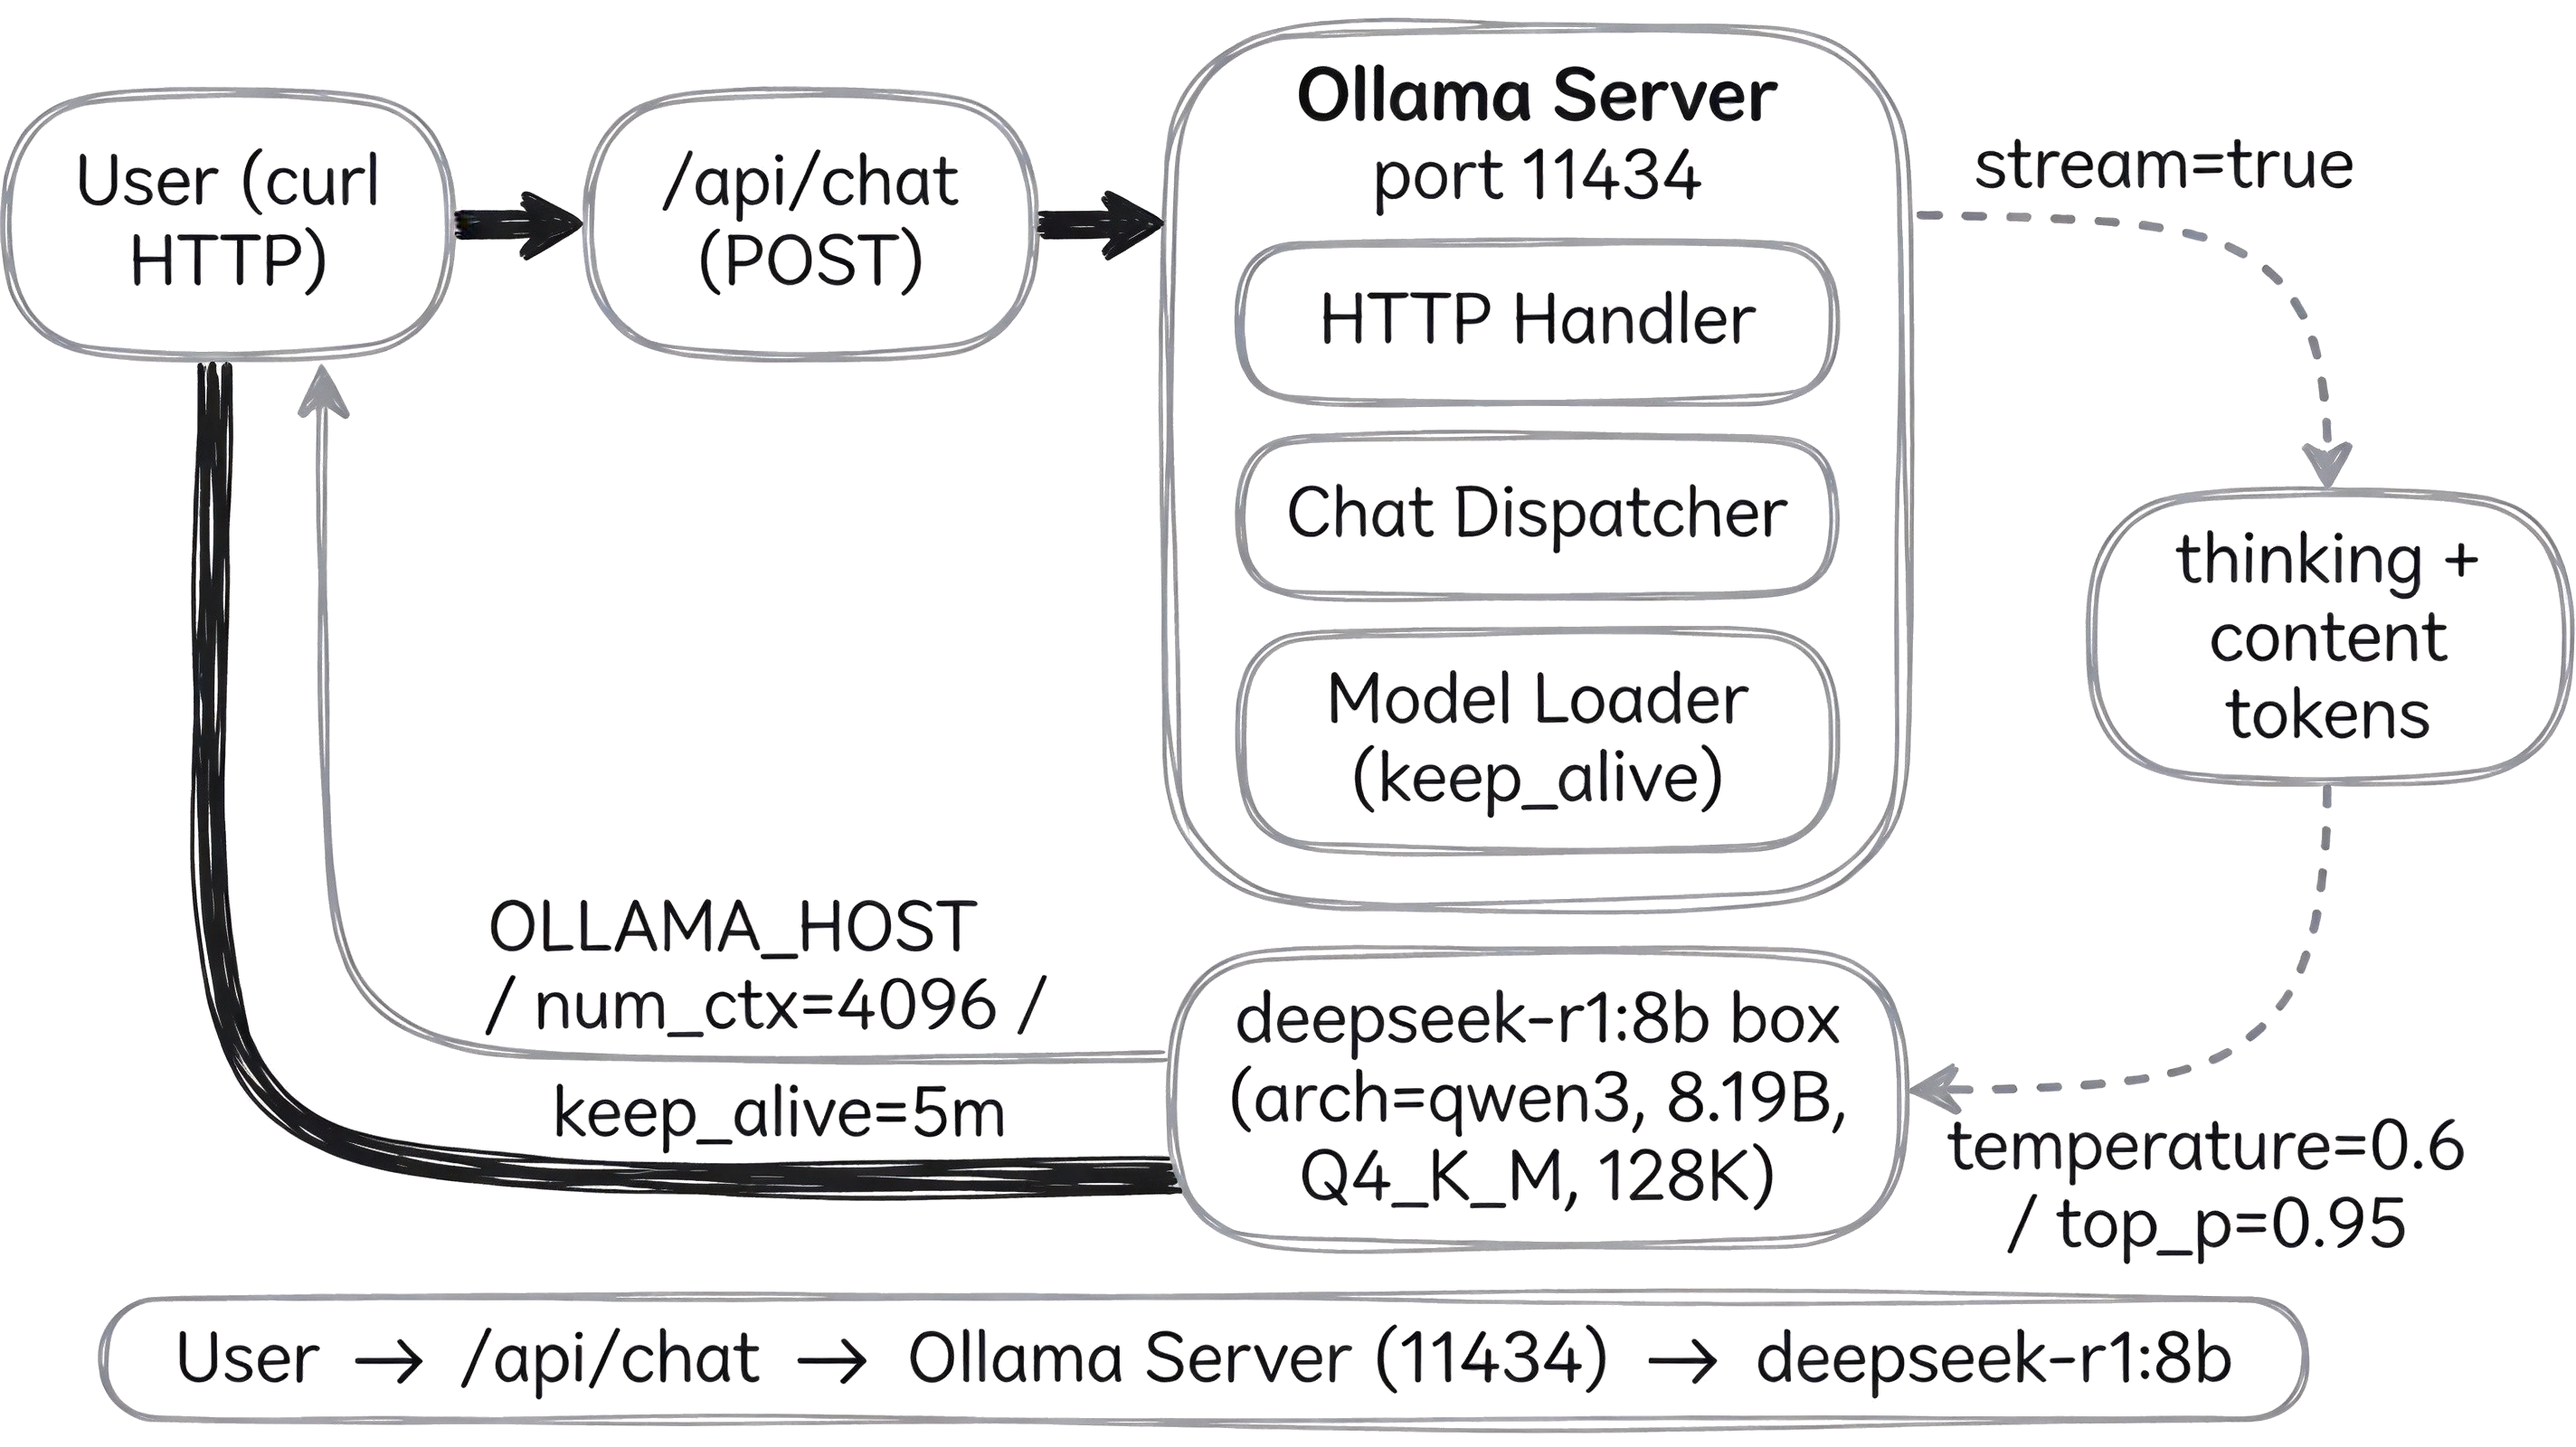
這張架構圖就是整條調用鏈路的走向——從左到右走一遍,一次帶 thinking 的請求的完整路徑就看清楚了。
| 概念 | 是什麼 | 類比 |
|---|---|---|
| Ollama | 把權重文件、運行參數和推理引擎(llama.cpp / MLX)打包成本地常駐服務的運行時 | 像本地的數據庫服務,裝好就有一個進程守在 11434 端口 |
| DeepSeek-R1 / 蒸餾版 | DeepSeek-R1 本身是 671B MoE 推理模型;Ollama 上常見的是蒸餾版(1.5b/8b/14b/32b/70b),預設 8b 即 DeepSeek-R1-0528-Qwen3-8B(Q4_K_M 量化,5.2 GB,128K 上下文) |
像 GitHub 倉庫裡的 release tag,同一個倉庫下不同規格,挑機器夠得動的那個 |
thinking 字段 |
/api/chat 響應裡 message.thinking 裝推理思考過程,message.content 裝最終回答;通過請求體 "think": true/false 或 CLI 的 /set think//set nothink 切換 |
像 LLM 的 inner monologue / 草稿區,思考在前面、答案在後面 |
num_ctx |
一次請求能看到的 token 上限,Ollama 預設 4096,超出歷史會被截斷;DeepSeek-R1 蒸餾版模型上限 128K,671b 主模型 160K | 像工作臺面積,放得下的材料在工作臺上用,放不下的就推到地上 |
keep_alive |
模型在記憶體裡停留的時間,預設 5m(5 分鐘);超出後自動卸載,下一次請求觸發重新加載 |
像酒店退房時間,超過時間房間就釋放,下一個客人來再重新辦入住 |
常見問題
curl: (7) Failed to connect to localhost port 11434
現象:命令行 curl 或客戶端連不上 11434,報 Connection refused,不是超時。
原因:Ollama 服務沒起來;或者只綁在別的地址上(容器裡最常見,容器內的 localhost 不是宿主機);或者被 HTTP_PROXY/HTTPS_PROXY/NO_PROXY 沒設 localhost/127.0.0.1 劫持。
Error: pull model manifest: file does not exist(或 model "deepseek-r1:8B" not found, try pulling it first)
現象:ollama pull deepseek-r1:8b 直接報 file does not exist,沒下任何東西;或者 /api/chat 調用時回 model not found。
原因:tag 是 exact string;常見錯例 deepseek-r1:8B(大寫)、deepseek-r1:8b-v2(不存在的量化檔)、OLLAMA_HOST 指向了別的機器。
相關文章:ollama pull deepseek-r1:8B 報 pull model manifest: file does not exist
CUDA error: out of memory(或進程被 kill / Linux dmesg 報 oom-kill)
現象:拉完後第一次推理直接被 kill;Linux 上 dmesg 報 OOM;有時換更小 tag 反而沒事。
原因:模型超過 VRAM/RAM;num_ctx=4096 預設推高 KV cache;上一個模型還在 keep-alive(預設 5 分鐘)緩存裡沒釋放。
響應裡 message.thinking 字段缺失,或按 message.reasoning_content 取值拿到 undefined
現象:調 /api/chat 返回 JSON 裡 message.content 正常但沒有 message.thinking;或者按雲 SDK 寫法在 message.reasoning_content 取值,拿到 undefined/null。
原因:Ollama API 字段名是 message.thinking,不是 DeepSeek 雲 API 的 message.reasoning_content;且需要請求體顯式 "think": true(不傳則按模型 thinking.default,多數情況下仍是 true,但寫出來最穩)。