跟着这篇走完,你会在本地把 Meilisearch 的混合检索(hybrid search)跑通:配好内置 embedder 后,同一个查询词分别用语义占比 0 / 0.5 / 1.0 三档去搜,亲眼看到“关键词命中”和“语义命中”是怎么被拧到一起排序的,再用 _rankingScore 看出每一条结果到底是靠哪条腿排上来的。整个过程 7 步,每步都有一条命令能验证自己做对了没有。localhost:7700 是 Meilisearch 的默认监听地址,master key 固定用 aSampleMasterKey,索引建新的 books_hybrid(还是系列那 6 本虚构书籍),模型用 BAAI/bge-small-zh-v1.5——你要是换了端口、key、索引名或模型,把示例值替换掉就行。这篇默认你已经装好并跑通了从零跑通 Meilisearch 本地搜索服务,安装、启动、异步任务轮询的套路全部复用第一篇。跟系列前两篇的区别说在前面:meilisearch-semantic-search 和 meilisearch-embedded-embedder 演示的都是 semanticRatio: 1.0 的纯语义模式,这篇专门玩中间值——语义分与关键词分合并排序、比例怎么调,正是混搜跟纯语义不一样的地方。
前置条件
| 项 | 要求 | 说明 |
|---|---|---|
| Meilisearch | v1.54.3 或更高 | 内置 embedder 和 hybrid 检索都已是稳定特性,低于这代版本接口行为可能有差异 |
| 前置文章 | 已跑通 meilisearch-local-search |
复用其安装/启动/master key/异步任务轮询套路;没跑通先回去补 |
| 网络 | 首次需能访问 HuggingFace | 模型首次使用时自动下载;完全离线或内网环境会卡在下载这一步 |
| master key | aSampleMasterKey |
与系列一致 |
| curl | 任意版本 | 全文用 curl 调 REST API |
先跑这条,确认第一篇的服务还活着。
curl http://localhost:7700/health{
"status": "available"
}返回 {"status":"available"} 就满足条件。要是返回 curl: (7) Failed to connect to localhost port 7700,说明服务没起——回第一篇第一步用 meilisearch --master-key="aSampleMasterKey" 重新启动,再回来。
第一步:建 books_hybrid 索引,传 6 本纯文本书(不带向量)
混合检索要做两件事:查关键词、查语义。语义这条路依赖向量,向量得挂在某个索引上,所以第一步先把索引和基础数据准备好——跟 meilisearch-embedded-embedder 篇一样,文档就是普通 JSON,向量后面由服务端自动生成,这一步不需要碰 _vectors。
索引走显式创建,指定主键 id,沿用系列惯例:
curl -X POST http://localhost:7700/indexes \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"uid":"books_hybrid","primaryKey":"id"}'
{
"taskUid": 40,
"indexUid": "books_hybrid",
"status": "enqueued",
"type": "indexCreation",
"enqueuedAt": "2026-10-12T10:00:00.000Z"
}接着传 6 本书。字段有 id、title、author 和 summary(书的简介,后面 documentTemplate 要把它拼进嵌入文本,决定语义能搜到什么):
curl -X POST http://localhost:7700/indexes/books_hybrid/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '[
    {"id":1,"title":"三体","author":"刘慈欣","summary":"仰望星空,写人类文明与三体文明星际博弈的科幻巨作"},
    {"id":2,"title":"球状闪电","author":"刘慈欣","summary":"以球状闪电为引的科幻小说,物理奇观与人生选择"},
    {"id":3,"title":"活着","author":"余华","summary":"写普通人在苦难中活下去的故事,农村家庭的伦理与温情"},
    {"id":4,"title":"许三观卖血记","author":"余华","summary":"写小人物靠卖血养家的故事,底层生活的坚韧与荒诞"},
    {"id":5,"title":"明朝那些事儿","author":"当年明月","summary":"用通俗笔法写明朝三百年历史,官场斗争与王朝兴衰"},
    {"id":6,"title":"万历十五年","author":"黄仁宇","summary":"从万历十五年切入,剖析明朝制度的运转与深层困境"}
  ]'
{
"taskUid": 41,
"indexUid": "books_hybrid",
"status": "enqueued",
"type": "documentAdditionOrUpdate",
"enqueuedAt": "2026-10-12T10:01:00.000Z"
}上传是异步的,任务队列(Meilisearch 把每个写操作排进一个任务队列,按 uid 逐个执行,写完状态变 succeeded)跑完才落库。等 taskUid: 41 变成 succeeded:
curl http://localhost:7700/tasks/41 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 41,
"indexUid": "books_hybrid",
"status": "succeeded",
"type": "documentAdditionOrUpdate",
"details": {
"receivedDocuments": 6,
"indexedDocuments": 6
}
}看到 indexedDocuments: 6 就说明 6 条都落库了。注意:现在这个索引还没有向量,只能做关键词检索——语义那条腿要等第二步配了 embedder 才有。
第二步:配置 huggingFace embedder(default),等全量自动嵌入完成
光有纯文本,混合检索的“语义腿”是空的。要让 Meilisearch 自己转向量,得在索引设置里声明一个 embedder。embedder(嵌入器)是一条“向量由谁生成、用什么模型、拿文档的哪些字段去嵌入”的配置;这里用 huggingFace 源——模型跑在你本机,不需要任何 API key,首次使用自动从 HuggingFace 下载。这一步不配,后面任何带 hybrid 参数的搜索请求都会直接返回 400。
curl -X PATCH http://localhost:7700/indexes/books_hybrid/settings/embedders \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"default":{"source":"huggingFace","model":"BAAI/bge-small-zh-v1.5","documentTemplate":"中文书籍,书名《{{doc.title}}》,作者 {{doc.author}},简介 {{doc.summary}}"}}'
{
"taskUid": 42,
"indexUid": "books_hybrid",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-12T10:05:00.000Z"
}default 是这条 embedder 的名字,后面搜索时 hybrid.embedder 要跟它逐字一致。documentTemplate(文档模板)用 Liquid 模板语法把每条文档拼成一段要送去嵌入的文本:{{doc.title}} 取文档的 title 字段。这里的 doc 是模板引擎的固定变量名,指“当前正在嵌入的这条文档”——建索引、传文档时都不用声明它,Meilisearch 渲染模板时自动把每条文档注入成 doc,所以模板里的字段名必须跟文档 JSON 的键一一对应,写成文档里不存在的键,整批嵌入会失败(见常见问题第 3 条)。语义检索比对的就是这段渲染文本,模板里放哪些字段,决定了能被什么样的查询搜到——把简介拼进去,“按内容搜”才有真实依据。
等模型下载 + 6 条文档全部嵌入完成(bge-small 权重约 90 多 MB,首次可能要几分钟)。轮询刚才的 taskUid:
curl http://localhost:7700/tasks/42 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 42,
"indexUid": "books_hybrid",
"status": "succeeded",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-12T10:05:00.000Z",
"startedAt": "2026-10-12T10:05:01.000Z",
"finishedAt": "2026-10-12T10:08:32.000Z"
}验证一条:把 embedder 设置读回来,确认配置落进去了。
curl http://localhost:7700/indexes/books_hybrid/settings/embedders -H "Authorization: Bearer aSampleMasterKey"{
"default": {
"source": "huggingFace",
"model": "BAAI/bge-small-zh-v1.5",
"documentTemplate": "中文书籍,书名《{{doc.title}}》,作者 {{doc.author}},简介 {{doc.summary}}"
}
}读到 {"default":{"source":"huggingFace",...}} 就对了。任务没 succeeded 之前去搜,索引还没有向量,搜出来跟普通关键词没区别——这个坑后面常见问题里专门有一条。
第三步:第一次混合搜索——semanticRatio 0.5 默认档,看 _rankingScore
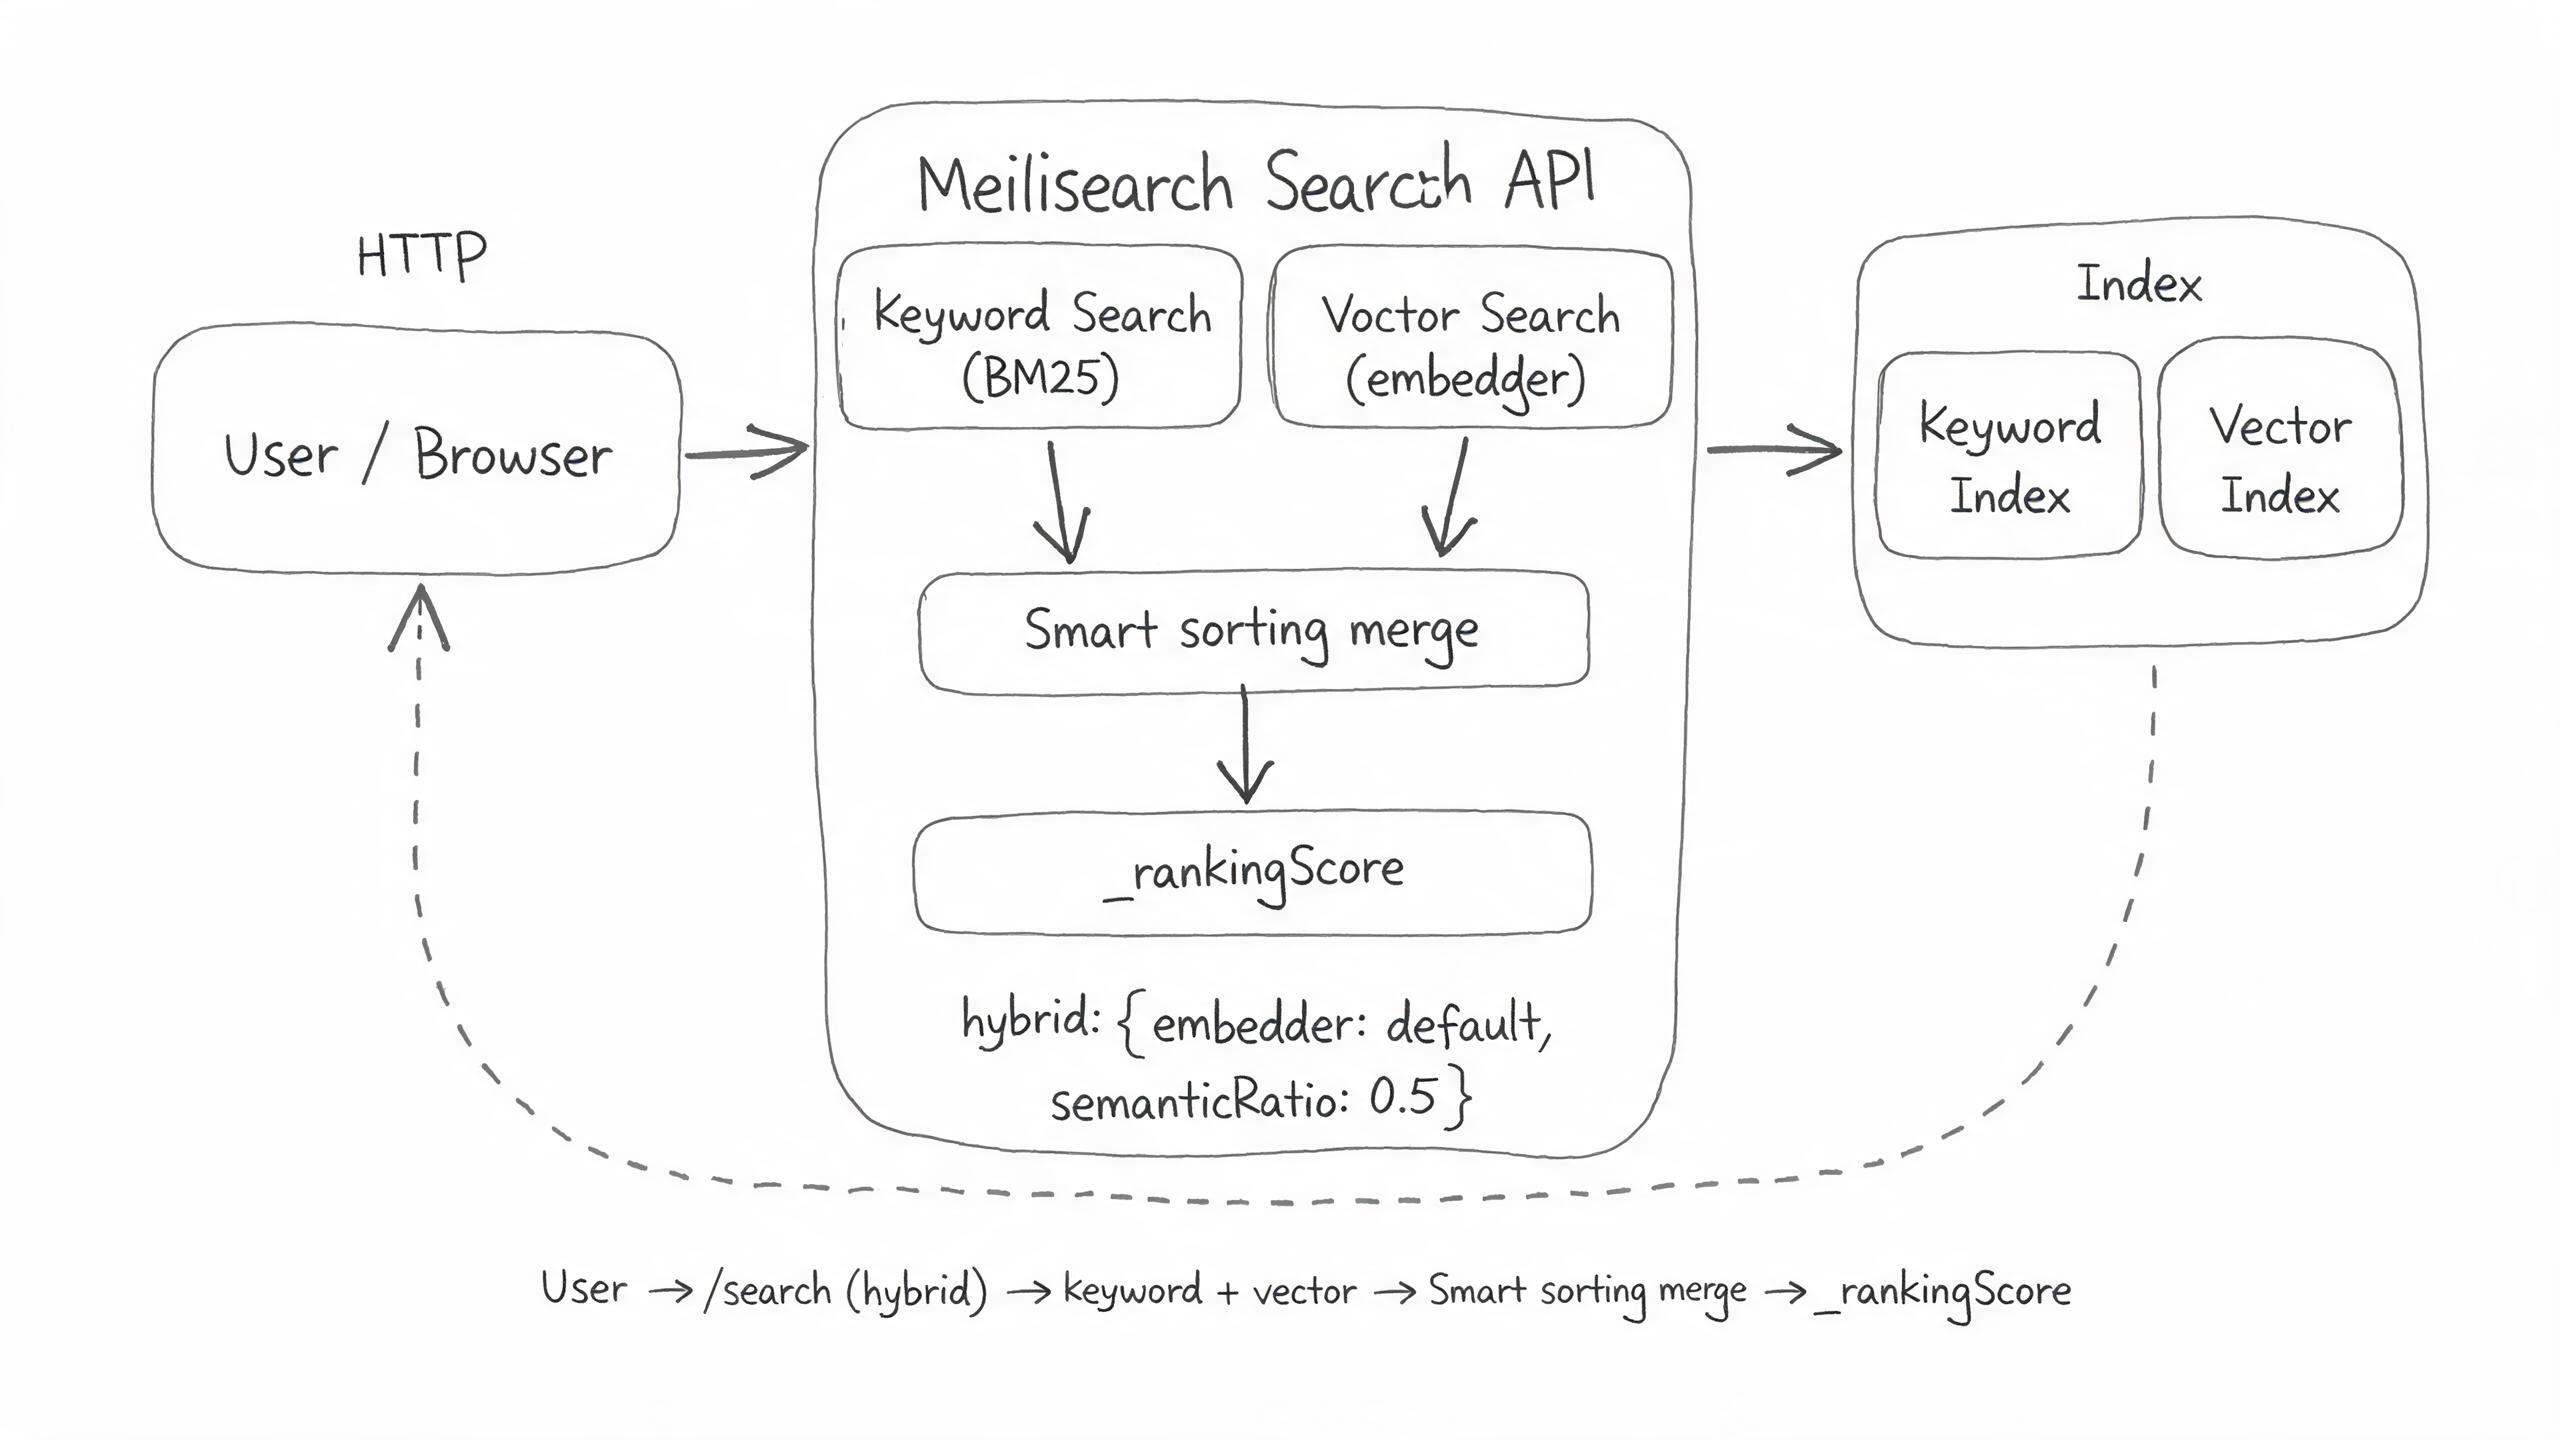
前两步证明了“向量生成了”,但这只说明语义腿有腿可走,还没证明混搜真的在混合。混合检索(hybrid search)是 Meilisearch 把关键词检索和语义(向量)检索并行跑一遍,再把两路结果合并排序的模式——不是简单拼接,而是一套能自动判断“这查询该偏哪边”的评分机制(官方叫 smart scoring)。这一步用一个既有字面命中、又有语义命中的查询,打开分数开关,看两路是怎么合并的。
查询「明朝三百年历史的通俗书」:文档里《明朝那些事儿》(id 5)的简介“用通俗笔法写明朝三百年历史”,四个词全都字面命中;《万历十五年》(id 6)只有“明朝”沾边。这是个关键词和语义大概率一致选 id 5 的查询,正好用来观察分数结构。
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
-d '{"q":"明朝三百年历史的通俗书","hybrid":{"embedder":"default","semanticRatio":0.5},"showRankingScore":true,"showRankingScoreDetails":true}'hybrid(混合检索参数)对象里 embedder 指名用哪条嵌入器(就是第二步配的 default),semanticRatio(语义占比)控制关键词与语义结果的比例:0 是纯关键词,1 是纯语义,0.5 是默认的均衡混合。showRankingScore: true 让每条结果带上 _rankingScore(相关性分数,0.0 到 1.0,越高越相关;v1.8 起语义分并入这个字段);showRankingScoreDetails: true 再附加分项明细。返回体按官方文档结构大致长这样(具体键名和分值以你本地实测为准):
{
  "hits": [
    {
      "id": 5,
      "title": "明朝那些事儿",
      "_rankingScore": 0.9,
      "_rankingScoreDetails": {
        "words": {"order": 0, "score": 0.9},
        "typo": {"order": 1, "score": 0.9},
        "vector": {"order": 6, "score": 0.62}
      }
    },
    {
      "id": 6,
      "title": "万历十五年",
      "_rankingScore": 0.78,
      "_rankingScoreDetails": {
        "words": {"order": 0, "score": 0.52},
        "typo": {"order": 1, "score": 0.52},
        "vector": {"order": 6, "score": 0.74}
      }
    }
  ],
  "query": "明朝三百年历史的通俗书",
  "processingTimeMs": 4,
  "estimatedTotalHits": 2
}
看 _rankingScoreDetails 里的两个分项就能理解排序:id 5 靠 words(关键词)拿了 0.9 的高分——四个查询词它全有;id 6 关键词分只有 0.52(就“明朝”一个词),但 vector(语义)分 0.74 高于 id 5 的 0.62,因为“从万历十五年切入剖析制度运转”和“三百年历史的通俗书”意思上更贴。混合模式下最终分是两路合并的结果,这就是“同时看字面和意思”的含义。
验证:确认返回里带 _rankingScore 且 estimatedTotalHits 非 0。要是返回 400,先看错误码——hybrid.embedder 写错名字报 invalid_search_embedder,hybrid 结构写错报 invalid_search_hybrid_query,排查入口见Meilisearch semanticRatio 越界或 embedder 名写错报错。
第四步:拧旋钮对照——同一查询在 0 / 0.5 / 1.0 三档下的命中差异
0.5 的均衡档看不出每一路的贡献,得把旋钮拧到两头对照。这一步是整篇的核心:用一个关键词只能按字面勉强捞到、语义能按意思补全的查询,对比“关键词命中”和“语义命中”的差异。
查询「仰望星空,讲人类文明命运的科幻巨作」。先看纯关键词档(semanticRatio: 0——不查 embedder,纯关键词):
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"仰望星空,讲人类文明命运的科幻巨作","hybrid":{"embedder":"default","semanticRatio":0},"showRankingScore":true}'
{
"hits": [
{
"id": 1,
"title": "三体",
"author": "刘慈欣",
"_rankingScore": 0.9
},
{
"id": 2,
"title": "球状闪电",
"author": "刘慈欣",
"_rankingScore": 0.31
}
],
"query": "仰望星空,讲人类文明命运的科幻巨作",
"processingTimeMs": 1,
"estimatedTotalHits": 2
}关键词档命中两条,但排位和分数说明问题:《三体》简介里「仰望星空、人类文明、科幻巨作」字面全在,拿 0.9;《球状闪电》简介里只有「科幻」一个词沾边,按默认的 last 匹配策略(从查询末词往前逐词放松)在最后一层才被捞进来,只有 0.31。关键词要的是字面重合,一句话里大多数字对不上,就把文档压在底部——这正是语义检索要补的短板:词汇鸿沟(用户说的话和文档写的话对不上)在《球状闪电》身上最典型。(具体命中与分值以本地实测为准。)
再把旋钮拧到纯语义档(semanticRatio: 1.0):
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"仰望星空,讲人类文明命运的科幻巨作","hybrid":{"embedder":"default","semanticRatio":1.0},"showRankingScore":true}'
{
"hits": [
{
"id": 1,
"title": "三体",
"author": "刘慈欣",
"_rankingScore": 0.82
},
{
"id": 2,
"title": "球状闪电",
"author": "刘慈欣",
"_rankingScore": 0.71
}
],
"query": "仰望星空,讲人类文明命运的科幻巨作",
"processingTimeMs": 3,
"estimatedTotalHits": 2
}语义档同样命中这两条,但排序依据换了:查询词自动转向量,跟库里每条文档的向量比相似度——《三体》简介里有“人类文明、星际博弈、科幻巨作”,《球状闪电》有“科幻小说、物理奇观”,查询描述的内容跟它们的意思对得上,靠的是第二步 documentTemplate 拼进去的 summary 字段,不是书名的先验。
轮到均衡档 semanticRatio: 0.5:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"仰望星空,讲人类文明命运的科幻巨作","hybrid":{"embedder":"default","semanticRatio":0.5},"showRankingScore":true}'
{
"hits": [
{
"id": 1,
"title": "三体",
"author": "刘慈欣",
"_rankingScore": 0.81
},
{
"id": 2,
"title": "球状闪电",
"author": "刘慈欣",
"_rankingScore": 0.7
}
],
"query": "仰望星空,讲人类文明命运的科幻巨作",
"processingTimeMs": 3,
"estimatedTotalHits": 2
}0.5 档也命中同样的两条,分数跟 1.0 档接近——《三体》字面也命中,关键词腿照样给它记分;《球状闪电》字面只沾「科幻」,分数主要靠语义腿贡献。合并方式不是简单的加权平均,而是把两路分数做可比化之后综合(Meilisearch 会对语义分做分布归一化,让它能跟关键词分同台比较)。三个档位对照下来:0 档按字面排序(球状闪电沉底)、1.0 档按语义排序(两条差距缩小)、0.5 档两者兼顾,语义腿的贡献一眼就分得出。
验证:三档各搜一次,0 档《三体》居首、《球状闪电》垫底,0.5 和 1.0 档两条分数差距明显缩小。semanticRatio 超出 0 到 1 的范围会直接 400 invalid_search_semantic_ratio,同样内链Meilisearch semanticRatio 越界或 embedder 名写错报错。
第五步:写入一条新文档,等自动嵌入完成后立即混合查询
前面验证的都是初始 6 条数据,混搜对之后写入的新数据还灵不灵?配好 embedder 后,新增文档入库时 Meilisearch 会同样自动转向量,这一步就验证这条写入路径。传一本新书《围城》,还是纯文本、不带向量:
curl -X POST http://localhost:7700/indexes/books_hybrid/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"id":7,"title":"围城","author":"钱钟书","summary":"写婚姻与人生的围城困局,知识分子的困惑与讽刺"}'
{
"taskUid": 43,
"indexUid": "books_hybrid",
"status": "enqueued",
"type": "documentAdditionOrUpdate",
"enqueuedAt": "2026-10-12T10:10:00.000Z"
}新文档也要先过一遍嵌入,照旧轮询任务号:
curl http://localhost:7700/tasks/43 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 43,
"indexUid": "books_hybrid",
"status": "succeeded",
"type": "documentAdditionOrUpdate",
"details": {
"receivedDocuments": 1,
"indexedDocuments": 1
}
}验证:用 0.5 档混搜一个能命中《围城》的查询——「婚姻是围城,困住人的故事」这个词,关键词腿能命中“婚姻、围城”(简介里都有),语义腿也指向围城,两条腿应该都把它顶上来:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"婚姻是围城,困住人的故事","hybrid":{"embedder":"default","semanticRatio":0.5},"showRankingScore":true}'
{
"hits": [
{
"id": 7,
"title": "围城",
"author": "钱钟书",
"_rankingScore": 0.85
}
],
"query": "婚姻是围城,困住人的故事",
"processingTimeMs": 3,
"estimatedTotalHits": 1
}hits 里出现 id: 7 的《围城》就对了——围城的 summary 写的是“写婚姻与人生的围城困局”,跟查询说的是同一件事,关键词腿和语义腿都支持它。写入路径验证通过。要是任务没跑完就去搜,新文档会搜不到,排查见Meilisearch 添加文档后立即搜索返回空结果。
第六步:更新一条文档,等自动重嵌入完成后再次查询
更新路径同理:改文档内容 → Meilisearch 重新给这条文档生成向量、替换旧向量。这一步把第五步的 id: 7 从《围城》改成《边城》,然后查两次验证。更新就是“同一条 id 再传一次”,POST /documents 对已存在的 id 是覆盖更新:
curl -X POST http://localhost:7700/indexes/books_hybrid/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"id":7,"title":"边城","author":"沈从文","summary":"写湘西边陲小镇的乡土爱情,纯净而忧伤的故事"}'
{
"taskUid": 44,
"indexUid": "books_hybrid",
"status": "enqueued",
"type": "documentAdditionOrUpdate",
"enqueuedAt": "2026-10-12T10:12:00.000Z"
}curl http://localhost:7700/tasks/44 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 44,
"indexUid": "books_hybrid",
"status": "succeeded",
"type": "documentAdditionOrUpdate",
"details": {
"receivedDocuments": 1,
"indexedDocuments": 1
}
}验证一:搜《边城》的查询,id: 7 以新书名命中:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"湘西边陲小镇的乡土爱情故事","hybrid":{"embedder":"default","semanticRatio":0.5},"showRankingScore":true}'
{
"hits": [
{
"id": 7,
"title": "边城",
"author": "沈从文",
"_rankingScore": 0.83
}
],
"query": "湘西边陲小镇的乡土爱情故事",
"processingTimeMs": 3,
"estimatedTotalHits": 1
}验证二:回搜第五步那个「婚姻是围城」的查询,id: 7 不再出现——旧向量已被替换:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"婚姻是围城,困住人的故事","hybrid":{"embedder":"default","semanticRatio":0.5},"showRankingScore":true}'
{
"hits": [],
"query": "婚姻是围城,困住人的故事",
"processingTimeMs": 2,
"estimatedTotalHits": 0
}id: 7 从“围城命中”变成“边城命中”,是更新触发自动重嵌入的直接证据:全程只改了文档文本,向量一次都没手动碰过。到这里,写入、更新、查询三条路径的混合检索全部验证完。
第七步(进阶):分场景调 semanticRatio,用 rankingScoreThreshold 过滤低分
不同场景的查询习惯不一样:搜书名、型号这类精确词,希望关键词腿主导(低 ratio);搜“我想要什么”这类描述,希望语义腿主导(高 ratio)。semanticRatio 是搜索时参数,同一个索引不同请求可以各用各的,不用改配置。这一步用同一个查询演示两档差异,再加一层低分过滤。
查询「底层小人物养家糊口的艰难」。先看低语义档 semanticRatio: 0.2——这个查询里的「底层」「小人物」「养家」在《许三观卖血记》(id 4)简介里全都字面存在,关键词腿应该精确锁定它:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"底层小人物养家糊口的艰难","hybrid":{"embedder":"default","semanticRatio":0.2},"showRankingScore":true}'
{
"hits": [
{
"id": 4,
"title": "许三观卖血记",
"author": "余华",
"_rankingScore": 0.88
}
],
"query": "底层小人物养家糊口的艰难",
"processingTimeMs": 2,
"estimatedTotalHits": 1
}低语义档下结果收敛:只有 id 4,因为「养家糊口」里“养家”两个字面命中,分数主要由关键词分贡献。再看高语义档 semanticRatio: 0.8:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"底层小人物养家糊口的艰难","hybrid":{"embedder":"default","semanticRatio":0.8},"showRankingScore":true}'
{
"hits": [
{
"id": 4,
"title": "许三观卖血记",
"author": "余华",
"_rankingScore": 0.86
},
{
"id": 3,
"title": "活着",
"author": "余华",
"_rankingScore": 0.43
}
],
"query": "底层小人物养家糊口的艰难",
"processingTimeMs": 3,
"estimatedTotalHits": 2
}语义占比拉高后,《活着》(id 3)进来了——它简介里“普通人在苦难中活下去”,跟“底层艰难生活”意思相近,但「底层」「小人物」「养家」一个词都没有,纯靠语义腿,所以分数只有 0.43,明显低于字面全中的 id 4。这就是语义腿“放进来”的候选:有价值,但分低。
低分候选多了会稀释结果页。用 rankingScoreThreshold(相关性分数阈值,0.0 到 1.0,低于阈值的结果直接不返回,官方建议从 0.5 起步)把 0.43 的《活着》过滤掉:
curl -X POST http://localhost:7700/indexes/books_hybrid/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"底层小人物养家糊口的艰难","hybrid":{"embedder":"default","semanticRatio":0.8},"rankingScoreThreshold":0.5}'
{
"hits": [
{
"id": 4,
"title": "许三观卖血记",
"author": "余华"
}
],
"query": "底层小人物养家糊口的艰难",
"processingTimeMs": 3,
"estimatedTotalHits": 1
}0.43 < 0.5 的被阈值拦下,只剩 id 4。到这一步,混搜的比例调优、低分过滤、写入/更新路径全部验证完。
核心概念
下面这张图是整条调用链路的走向:一个查询进 Meilisearch,关键词和语义两条路并行跑,分数合并后统一排序输出。
| 概念 | 是什么 | 类比 |
|---|---|---|
| 混合检索(hybrid search) | 关键词检索与语义(向量)检索并行执行后合并排序的搜索模式 | 查重名再查意思,两边都查 |
| semanticRatio | 搜索时参数,0.0 到 1.0,控制关键词与语义结果的比例,默认 0.5 | 音量旋钮,拧到哪头听哪头 |
| embedder | 索引设置里声明“向量由谁生成、用什么模型、嵌入哪些字段”的配置项 | 快递柜储物格,声明了谁送货、货多长 |
| smart scoring | 精确词自动偏关键词、描述词自动偏语义的合并评分机制 | 分诊台,根据症状分科室 |
| _rankingScore | 每条结果 0.0 到 1.0 的综合相关性分数,v1.8 起语义分并入其中 | 体检总分 |
| 词汇鸿沟 | 用户查询用词与文档用词对不上的现象 | 你说“爆米花机”,文档里写“玉米膨化设备” |
| rankingScoreThreshold | 低于阈值的低分结果直接不返回的过滤参数 | 及格线,线下不发榜 |
常见问题
invalid_search_semantic_ratio / invalid_search_embedder
现象:带 hybrid 的搜索返回 400,错误码 invalid_search_semantic_ratio 或 invalid_search_embedder。
原因:前者是 semanticRatio 超出了 0.0 到 1.0 的范围(比如写了 1.5 或字符串 "0.5");后者是 hybrid.embedder 写的名字跟索引 settings 里配置的 embedder 名对不上(配置叫 default 却写了 "Default")。两个都是请求参数校验失败,同步 400,改完重发即可。
配完 embedder 立刻搜索,结果跟普通关键词一样
现象:第二步配完 embedder 马上搜,hits 是纯关键词结果甚至为空,语义完全没生效。
原因:嵌入是异步任务,模型下载加全量嵌入还没跑完你就去搜了,索引里还没有向量。settingsUpdate / documentAddition 任务没到 succeeded,混搜的语义腿等于空跑。轮询 taskUid 到 succeeded 再搜。
template_rendering_error
现象:提交 embedder 配置或改 documentTemplate 后任务变成 failed,error.code 是 template_rendering_error,message 含 “missing field in document”。
原因:documentTemplate 里用 {{doc.xxx}} 引用了文档中不存在的字段,整批嵌入失败。修法:把模板改回只引用真实存在的字段,或用 {% if doc.xxx %} 包一层守卫,改完任务 succeeded 再继续。
相关文章:Meilisearch documentTemplate 引用缺失字段报 template_rendering_error