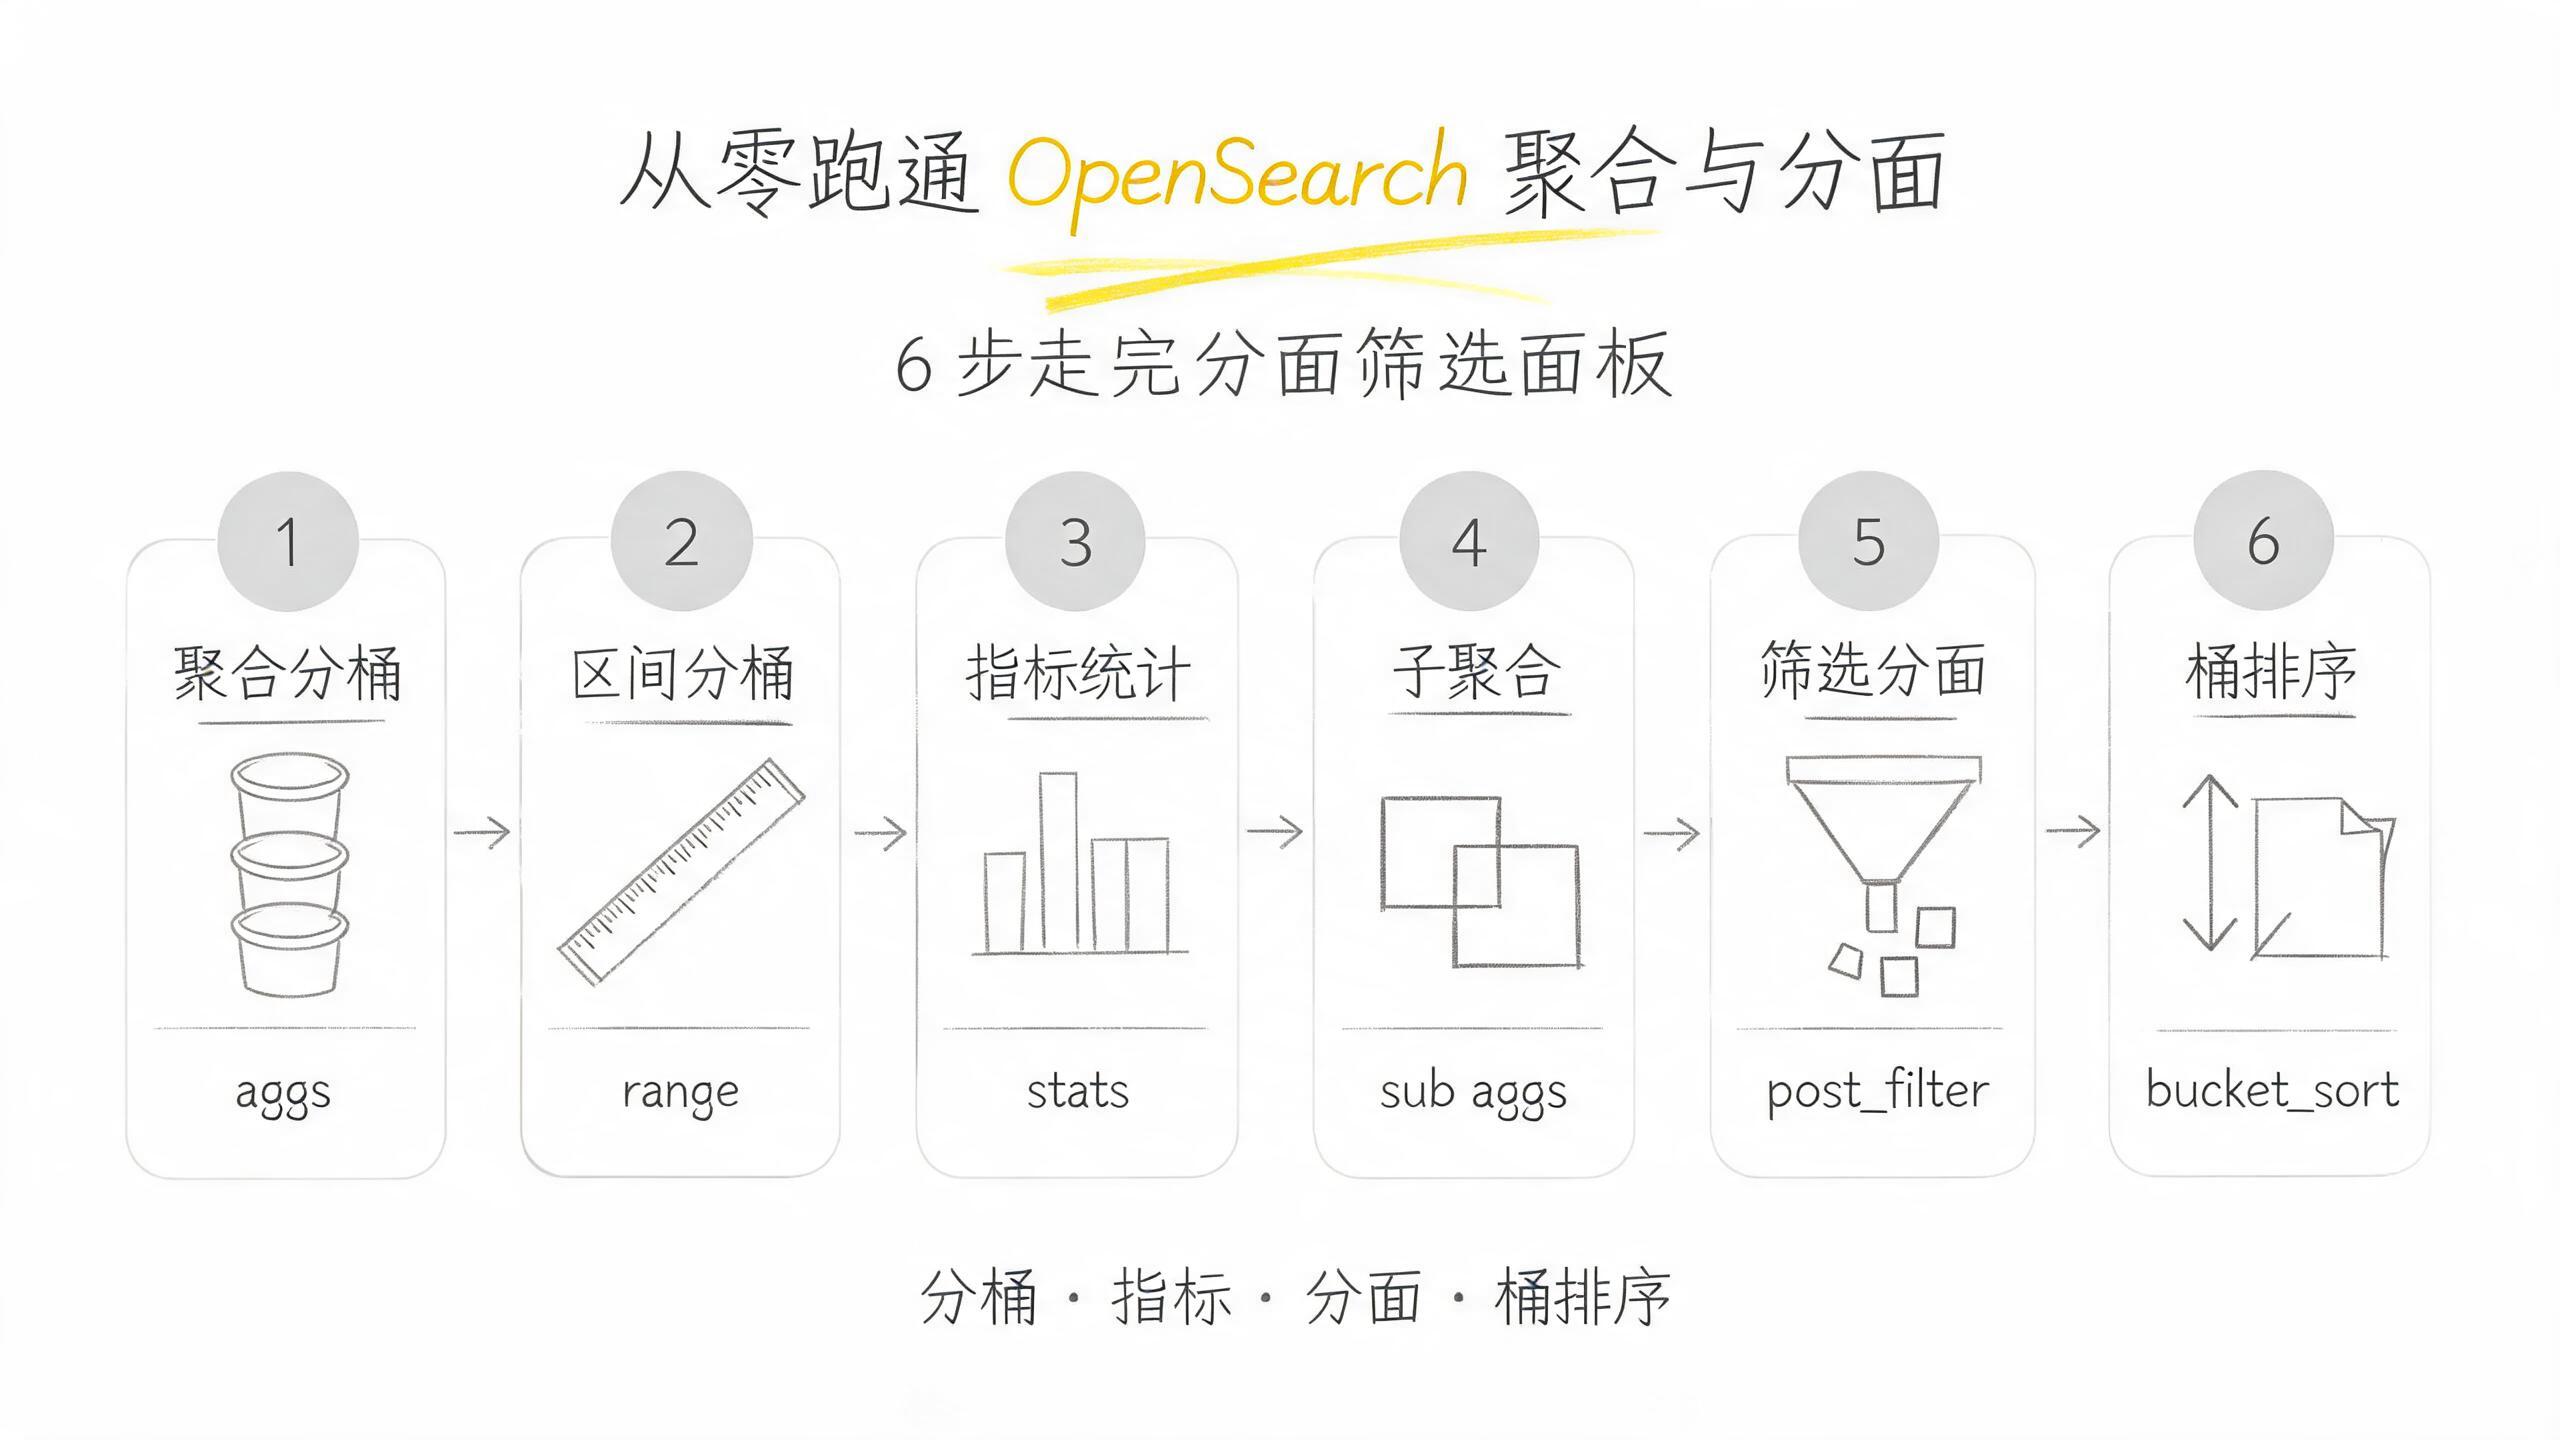
搜索结果页上那排「剧情 3 / 科幻 1 / 纪录片 1」的筛选数字,还有「按年份分布」的柱状图,靠的都是聚合(aggregation)。搜索解决「哪些文档命中」,聚合解决「命中的文档按某个字段怎么分组、每组多少、每组里的数值怎么分布」。这篇不重新建索引,直接拿从零跑通 OpenSearch 本地搜索服务里的 movies 索引和 5 条数据,六步从最简单的 terms 桶走到带计数的分面面板。
文中沿用第一篇的固定值:端口 9200、用户 admin、示例密码 Devfix@2026、索引 movies、OpenSearch 镜像 latest(3.9.0)。如果你还没跑通第一篇,先回去把容器起起来、数据导进去,再回来。
前置条件
| 项 | 要求 | 说明 |
|---|---|---|
| 已完成 | 从零跑通 OpenSearch 本地搜索服务 | 本文复用它的容器、密码、movies 索引和 5 条电影数据 |
| 数据 | movies 索引里有 5 条文档 |
第一篇最后删了 1 条的话只有 4 条,重新跑一次 bulk 即可 |
| curl | 任意版本 | 全文用 curl 调 REST API |
| 记忆负担 | 无 | 聚合命令都是同一条 _search,只换 aggs 里的内容 |
先自检两件事:文档数对不对、genre 是不是 keyword。
curl -sk -u admin:Devfix@2026 "https://localhost:9200/movies/_count?pretty"
curl -sk -u admin:Devfix@2026 "https://localhost:9200/movies/_mapping?pretty"
count 应该是 5,mapping 里 genre 的类型是 keyword。如果你在第一篇第六步删过文档,count 会是 4——把当时那个 movies.ndjson 再 bulk 一次就恢复成 5。genre 不是 keyword 的话,第一步就会撞上后面 FAQ 第 1 项那个报错。
第一步:先看「桶」——terms 聚合
聚合请求和搜索请求是同一个接口,区别在于多了一个 aggs 字段。先数一下每个类型有几部电影:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "aggs": { "by_genre": { "terms": { "field": "genre" } } }
  }'
{
"hits": {
"total": { "value": 5, "relation": "eq" },
"max_score": null,
"hits": []
},
"aggregations": {
"by_genre": {
"doc_count_error_upper_bound": 0,
"sum_other_doc_count": 0,
"buckets": [
{ "key": "drama", "doc_count": 3 },
{ "key": "scifi", "doc_count": 1 },
{ "key": "documentary", "doc_count": 1 }
]
}
}
}怎么读这份响应:
size: 0表示不要命中列表,只看聚合。不加这一项,hits会塞 10 条文档进来,白算一遍。aggregations.by_genre.buckets就是「桶」:每个key是一个类型,doc_count是这个类型下的文档数。by_genre是我们给这个聚合起的名字,响应里原样还回来。- 桶的默认顺序是
doc_count降序。scifi和documentary都是 1,谁先谁后不保证——想要稳定顺序,加"order": { "_key": "asc" }。
这一步的验证标准:三个桶的计数是 3、1、1,加起来等于 hits.total.value。对不上说明数据不是 5 条,回前置条件重导。
这里有个必须提前说清的边界:terms 的 field 只能是 keyword、数字、ip、布尔或日期字段。genre 能聚合,是因为第一篇建索引时把它映射成了 keyword;换成 title 这种 text 字段会直接 400,原因和修法见下面 FAQ 第 1 项。
第二步:数值用 range 分桶
genre 是离散值,切桶很自然。year 是数字,如果直接 terms,一个年份一个桶,1939、2013、2015……切得比电影还碎,没意义。数字字段该用 range,自己定区间:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "aggs": {
      "by_period": {
        "range": {
          "field": "year",
          "ranges": [
            { "from": 1930, "to": 2000 },
            { "from": 2000, "to": 2020 },
            { "from": 2020, "to": 2030 }
          ]
        }
      }
    }
  }'
{
"aggregations": {
"by_period": {
"buckets": [
{ "key": "1930.0-2000.0", "from": 1930.0, "to": 2000.0, "doc_count": 1 },
{ "key": "2000.0-2020.0", "from": 2000.0, "to": 2020.0, "doc_count": 3 },
{ "key": "2020.0-2030.0", "from": 2020.0, "to": 2030.0, "doc_count": 1 }
]
}
}
}对一下数据:1939 落在第一段,2013、2015、2018 落在第二段,2021 落在第三段,1 + 3 + 1 = 5。
这里有个容易记反的规则:区间是左闭右开,from 包含、to 不包含。所以 2000 年的电影会进 2000.0-2020.0,不会进 1930.0-2000.0。官方文档的原话是「响应包含 from 的值、不包含 to 的值」。
验证标准:三个桶加起来还是 5,且 2020 这个边界值如果存在,一定在 2020.0-2030.0 里。
第三步:每个桶算指标——stats
前面两步数的都是「有几条」。想知道「这些电影最早哪年、最晚哪年、平均哪年」,用指标聚合。stats 一次给全五个数:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "aggs": { "year_stats": { "stats": { "field": "year" } } }
  }'
{
"aggregations": {
"year_stats": {
"count": 5,
"min": 1939.0,
"max": 2021.0,
"avg": 2001.2,
"sum": 10006.0
}
}
}算一遍对得上:1939 + 2013 + 2021 + 2018 + 2015 = 10006,除以 5 是 2001.2。count 是参与计算的文档数,不是字段的取值个数。
验证标准:sum 除以 count 等于 avg,min/max 落在你的数据范围内。这个自洽关系可以拿来检查任何一份 stats 响应。
指标聚合和桶聚合是两类东西:terms、range 负责「怎么分组」,avg、sum、stats 负责「每组算个什么数」。下面把它们合起来用。
第四步:桶里套桶(子聚合)
结果页要的往往是「每个类型各有几部,平均年份是多少」——一个桶聚合,每个桶里再挂一个指标聚合:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "aggs": {
      "by_genre": {
        "terms": { "field": "genre" },
        "aggs": { "year_stats": { "stats": { "field": "year" } } }
      }
    }
  }'
{
"aggregations": {
"by_genre": {
"buckets": [
{
"key": "drama",
"doc_count": 3,
"year_stats": { "count": 3, "min": 1939.0, "max": 2015.0, "avg": 1989.0, "sum": 5967.0 }
},
{
"key": "scifi",
"doc_count": 1,
"year_stats": { "count": 1, "min": 2021.0, "max": 2021.0, "avg": 2021.0, "sum": 2021.0 }
},
{
"key": "documentary",
"doc_count": 1,
"year_stats": { "count": 1, "min": 2018.0, "max": 2018.0, "avg": 2018.0, "sum": 2018.0 }
}
]
}
}
}写法上只有一个变化:把子聚合放进 aggs 字段,和父聚合的 terms 平级。drama 的 year_stats 只统计那 3 部 drama,不会串到别的桶里。核对一下:drama 三部是 1939、2013、2015,和是 5967,平均 1989。
验证标准:每个桶的 doc_count 等于该桶 year_stats.count。不等说明数据里有年份缺失的文档,stats 只统计有值的文档。
这一步之后,一块分面面板需要的数据已经齐了。接下来是它最容易翻车的地方:用户点了筛选项之后,这些数字会变成什么样。
第五步:筛选与分面并存——query 与 post_filter
假设用户点了「只看 scifi」。最直觉的写法是把条件写进 query:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "query": { "term": { "genre": "scifi" } },
    "aggs": { "by_genre": { "terms": { "field": "genre" } } }
  }'
{
"hits": { "total": { "value": 1, "relation": "eq" } },
"aggregations": {
"by_genre": {
"buckets": [ { "key": "scifi", "doc_count": 1 } ]
}
}
}列表只剩 1 条没问题,但分面也只剩 scifi: 1——另外两个类型的计数全没了。用户想切回 drama 时,界面上已经没有这个选项。
这就是 query 和 post_filter 的分界线:query 在聚合之前执行,决定聚合能看到哪些文档;post_filter 在聚合之后执行,只裁命中列表。把同一个条件挪到 post_filter:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "post_filter": { "term": { "genre": "scifi" } },
    "aggs": { "by_genre": { "terms": { "field": "genre" } } }
  }'
{
"hits": { "total": { "value": 1, "relation": "eq" } },
"aggregations": {
"by_genre": {
"buckets": [
{ "key": "drama", "doc_count": 3 },
{ "key": "scifi", "doc_count": 1 },
{ "key": "documentary", "doc_count": 1 }
]
}
}
}hits.total.value 还是 1,但分面保留了全集:drama 3、documentary 1 都还在,用户可以随时切过去。这就是筛选面板该有的样子。
官方 faceted search 教程把这个行为叫「保持筛选期间的分面选项」,用的就是 post_filter,原话是它在聚合算完之后过滤搜索结果,因此分面反映的是未过滤的数据集。
那什么时候该用 query?关键词搜索就是典型:用户输入「wind」,这个条件本来就该缩小统计范围,聚合跟着收窄是正确行为。判断标准很简单——这个条件是不是用户正在输入或选择的搜索意图?是,写 query;它只是结果页上追加的一层筛选?写 post_filter。
还有第三种需求:列表要裁,但某个维度的统计要跟着筛选走(比如「选了 scifi 之后,各年份分布变成什么样」)。这时用 filter 聚合,它生成一个独立的桶,桶内子聚合只在 matching 的文档上算,不会影响旁边的其他分面:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "aggs": {
      "all_genres": { "terms": { "field": "genre" } },
      "scifi_years": {
        "filter": { "term": { "genre": "scifi" } },
        "aggs": { "by_year": { "terms": { "field": "year" } } }
      }
    }
}'验证标准:post_filter+aggs 与 query+aggs 的 hits.total.value 相同,但前者桶数是 3、后者是 1。两个数字对上了,说明你抓住了这条分界线。
第六步:bucket_sort 排序与截断
分面计数对了,还剩两个问题:桶按什么顺序展示、最多展示几个。terms 的默认顺序是文档数降序,前端如果想按「平均年份最新」排,就得用 bucket_sort:
curl -sk -u admin:Devfix@2026 -X GET "https://localhost:9200/movies/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "size": 0,
    "aggs": {
      "by_genre": {
        "terms": { "field": "genre" },
        "aggs": {
          "avg_year": { "avg": { "field": "year" } },
          "top_genres": {
            "bucket_sort": {
              "sort": [ { "avg_year": { "order": "desc" } } ],
              "size": 2
            }
          }
        }
      }
    }
  }'
{
"aggregations": {
"by_genre": {
"buckets": [
{ "key": "scifi", "doc_count": 1, "avg_year": { "value": 2021.0 } },
{ "key": "documentary", "doc_count": 1, "avg_year": { "value": 2018.0 } }
]
}
}
}三个桶按平均年份从新到旧排是 scifi(2021)、documentary(2018)、drama(1989),size: 2 把第三个截掉,只留前两个。
bucket_sort 是父级管道聚合,它排的是父聚合产出的桶,不改变桶里的文档数。sort、from、size 三个参数至少给一个,只给 size 就是纯截断:想展示前 3 个热门类型,就写 { "bucket_sort": { "size": 3 } },桶的顺序沿用 terms 的默认排序。
验证标准:桶的数量等于 size,顺序与 avg_year 的降序一致。
到这里六步走完:能按字段切桶、按区间切桶、算指标、嵌套、在筛选时保住分面计数、控制桶的顺序和条数。结果页需要的聚合能力基本齐了。
核心概念
把六步压成一张图,就是聚合的三段式:一条 query 先圈出文档集,aggs 在这个集合上按字段切桶,桶里的指标再对每条文档的字段值做计算。
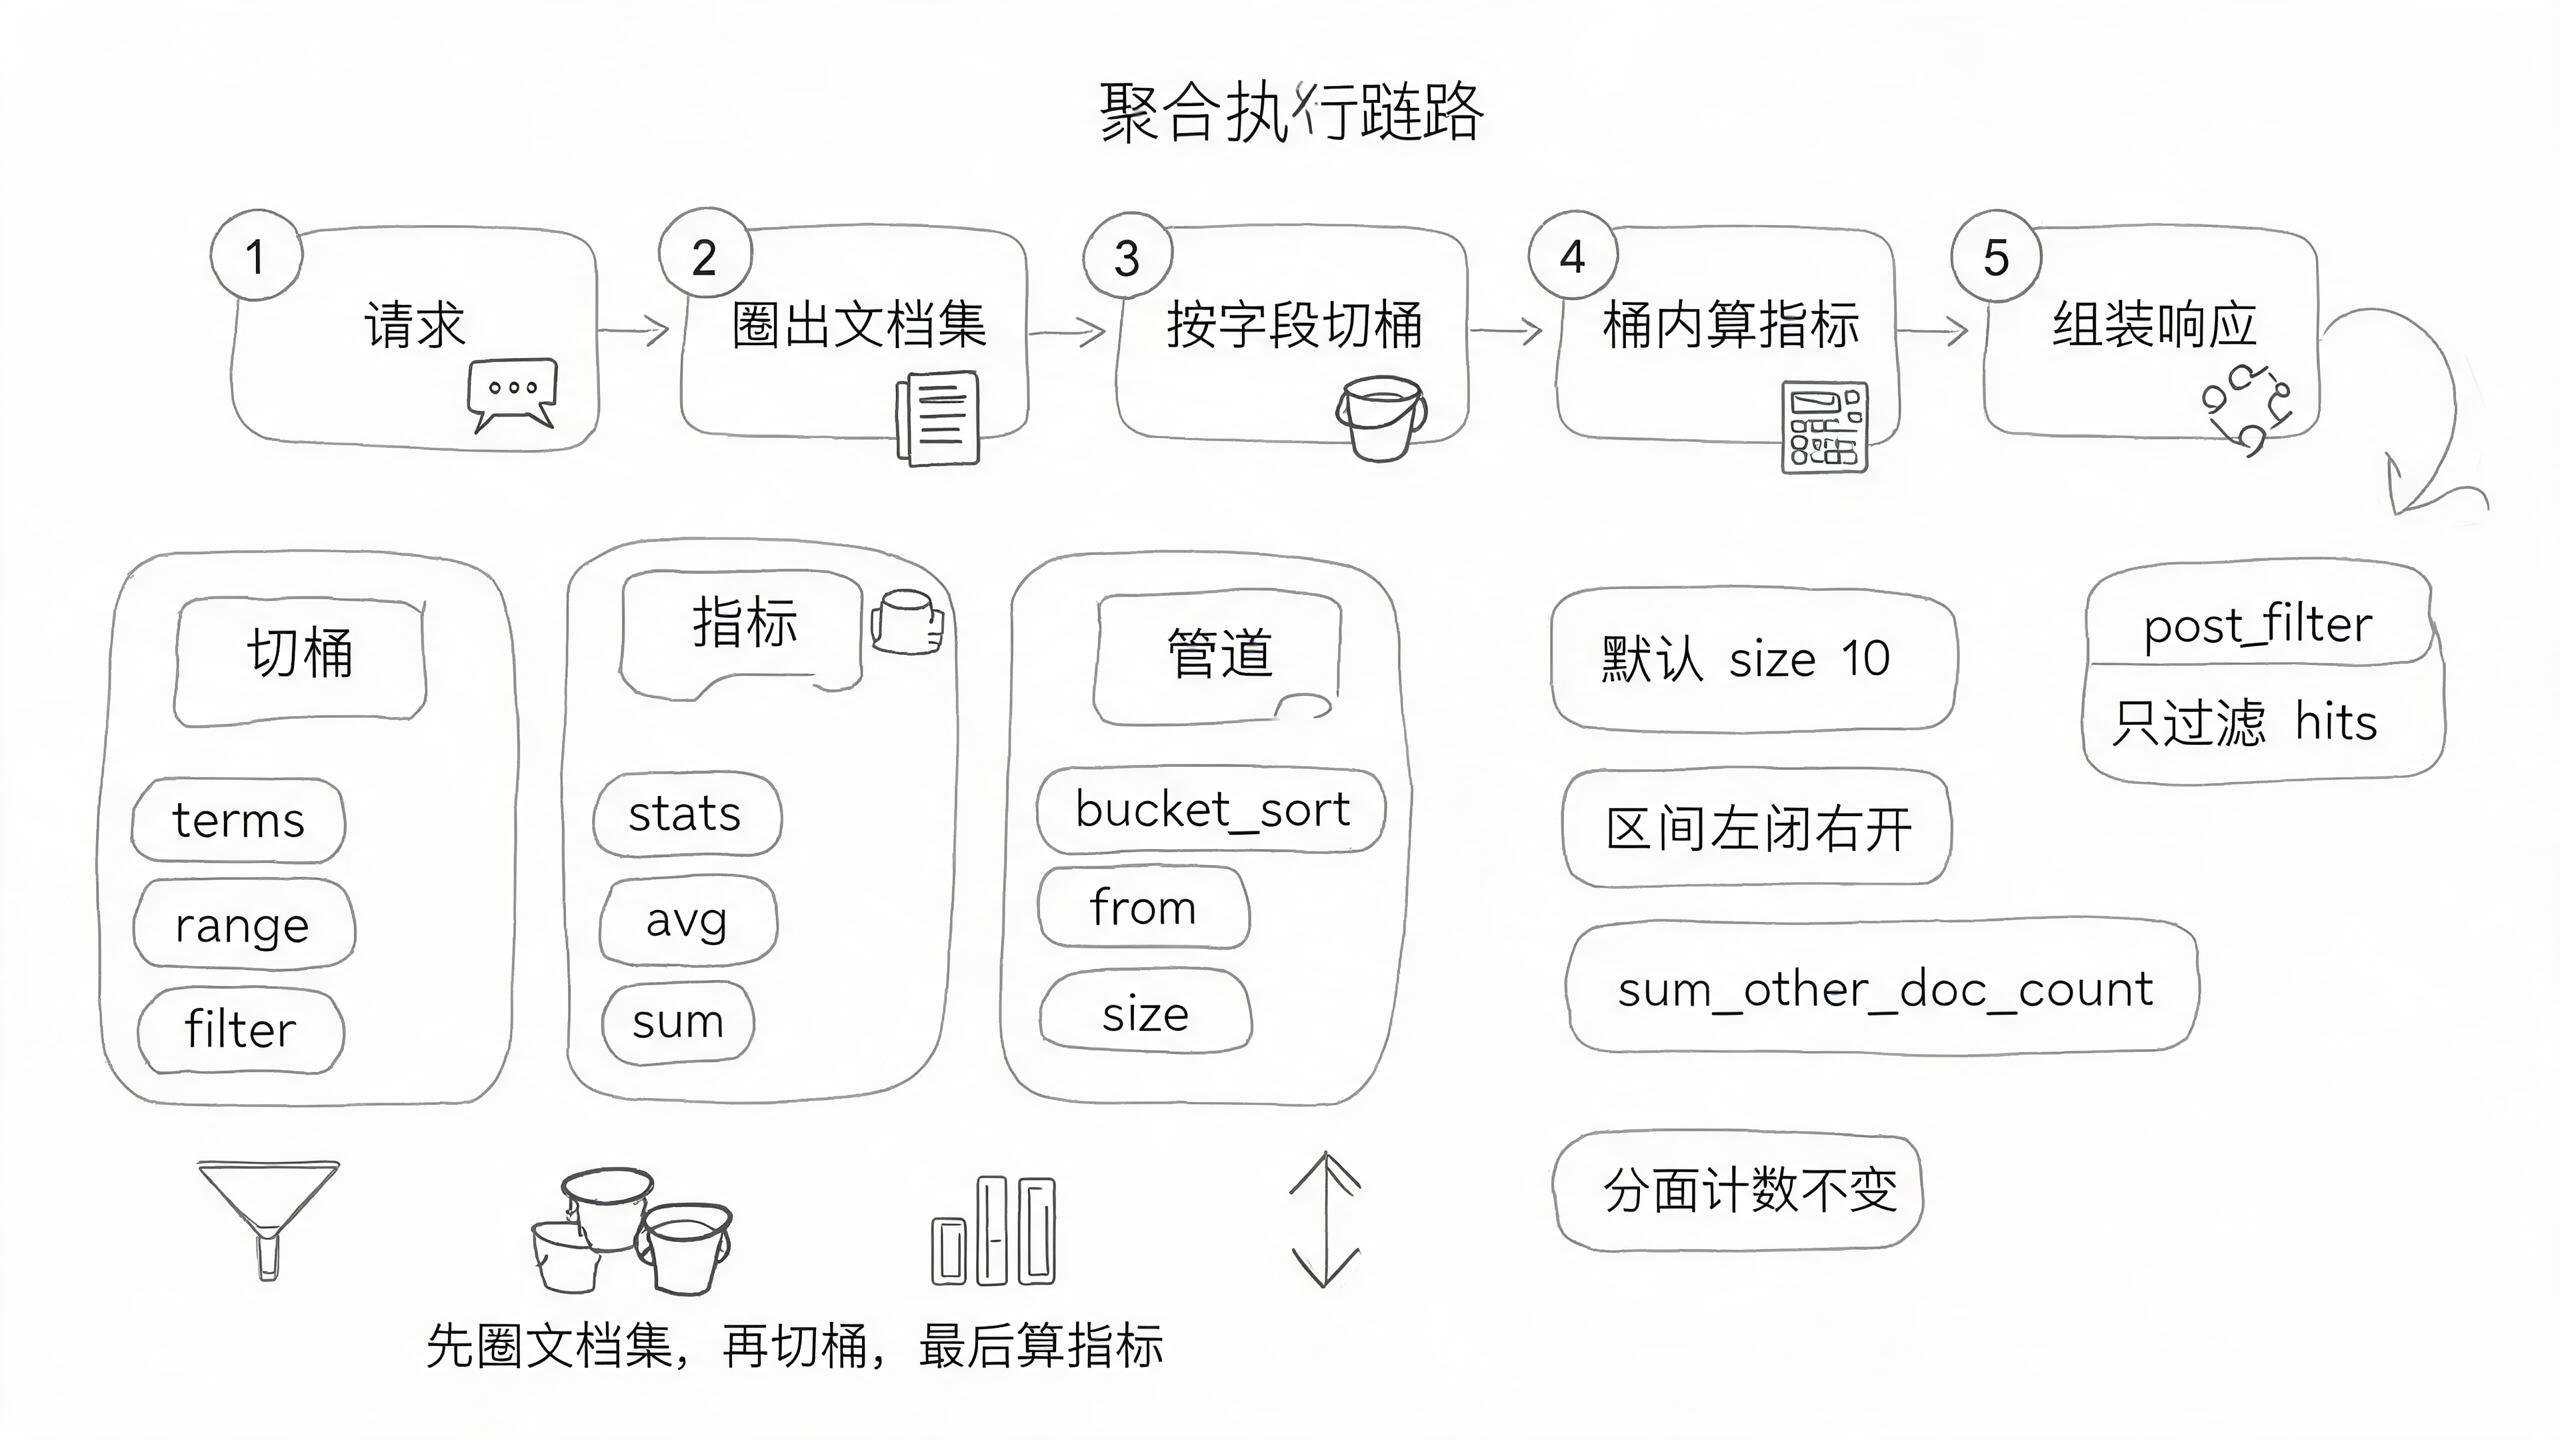
| 概念 | 是什么 | 类比 |
|---|---|---|
| 聚合(aggregation) | 对命中文档做分组统计的请求单元,写在 aggs 里 |
像 SQL 的 GROUP BY 加聚合函数 |
| 桶(bucket) | 按字段值或区间分出来的一组文档,带 doc_count |
像分组后的每一组 |
| 指标(metric) | 对桶内文档的某个数值字段做计算,如 avg、sum、stats |
像 AVG()、SUM() |
| 子聚合 | 挂在桶下面的聚合,只在该桶的文档上计算 | 像先分组再对每组算一次 |
| 分面(facet) | 结果页上「类型 3 / 科幻 1」这类带计数的筛选项,本质是桶聚合 | 像电商筛选栏 |
| 作用域 | aggs 能看到的文档集,由 query 决定;post_filter 不参与这个过程 |
像统计口径 |
| 管道聚合 | 对已有桶再做一层处理,如 bucket_sort 排序和截断 |
像对分组结果再排序取前 N |
常见问题
对 title 做聚合报 fielddata 错误
现象:把第一步的 field 从 genre 换成 title,请求返回 400 illegal_argument_exception,reason 里写着 Text fields are not optimised for operations that require per-document field data like aggregations and sorting。
原因:title 是 text 字段,写入时被分析器切成词条,默认不建 doc values,聚合读不到「每篇文档的字段原值」;genre 是 keyword,天然支持聚合。想让标题也能分面,得给它加 .keyword 子字段并重建索引,或者临时开 fielddata——后者会把字段值全加载进堆内存。
加了筛选条件后分面计数只剩一个
现象:分面面板点选「scifi」后,请求里的 hits 只剩 1 条,同时 by_genre 的桶也只剩 scifi: 1,其他类型的计数消失。
原因:筛选条件写进了 query,而 aggs 的作用域就是 query 命中的文档集,聚合只能在这个子集里数数。把同一个条件挪到 post_filter,聚合在过滤之前计算,分面就能保留全集计数。
terms 桶总是只有 10 个
现象:字段有十几个取值,terms 聚合只返回 10 个桶,剩下的类型在筛选面板上不见了,接口没有报错。
原因:terms 的 size 默认 10,被丢掉的桶的文档数汇总在 sum_other_doc_count。多分片下每个分片只上报 size * 1.5 + 10 个候选,计数还可能有误差,看 doc_count_error_upper_bound。