
跟著這篇走完,你會在終端把 Meilisearch 的純向量語義搜索跑通:用本地中文嵌入模型 bge-small-zh-v1.5 把文檔轉成 512 維向量,通過 userProvided 類型的 embedder 存進 Meilisearch,檢索時把 semanticRatio 拉到 1.0,讓結果只看語義、不看關鍵詞。整個過程 6 步,每步都有一條命令能驗證自己做對了沒有。
動手前先交代下環境。localhost:7700 是 Meilisearch 的預設監聽地址,master key 固定用 aSampleMasterKey(與系列一致),索引固定用 books_vec(本篇新建,不動前面的 books_zh、books_sort),示例文檔還是那 6 條虛構書籍;你要是換了端口、master key、索引名或嵌入模型,把示例值替換掉就行。這篇預設你已經裝好並跑通了從零跑通 Meilisearch 本地搜索服務,還沒跑起來先回去把服務起了再回來,安裝、啟動、異步任務輪詢的套路全部複用第一篇。向量檢索這事有個前提你要知道:Meilisearch 自己不做嵌入,它只管存向量、比向量,向量得你這邊生成好了再餵給它——這正是這篇和前面幾篇最大的不同。
前置條件
| 項 | 要求 | 說明 |
|---|---|---|
| Meilisearch | v1.54.3 或更高 | 與系列一致;embedder(嵌入器)設定接口 v1.6 起才有,低於這個版本照做會報錯 |
| 前置文章 | 已跑通 meilisearch-local-search |
複用其安裝/啟動/master key/異步任務輪詢套路;沒跑通先回去補 |
| Python | 3.10–3.12 + sentence-transformers | Intel Mac 需先鎖 torch==2.2.2(PyTorch 2.3 起不再出 macOS x86_64 包) |
| master key | aSampleMasterKey |
與系列一致 |
| curl | 任意版本 | 全文用 curl 調 REST API |
先跑這條,確認第一篇的服務還活著。
curl http://localhost:7700/health{
"status": "available"
}返回 {"status":"available"} 就滿足條件。要是返回 curl: (7) Failed to connect to localhost port 7700,說明服務沒起——回第一篇第一步用 meilisearch --master-key="aSampleMasterKey" 重新啟動,再回來。
第一步:確認服務在跑、版本夠不夠新
向量檢索不是 Meilisearch 出生就有的能力,embedder 設置接口在 v1.6 才出現,後面第二步就要用這個接口。版本太低的話,/settings 上會直接不認 embedders 這個字段,所以第一步先把版本確認掉,省得照老版本教程做了一路、最後卡在設定接口上。
curl http://localhost:7700/version -H "Authorization: Bearer aSampleMasterKey"{
"commitSha": "7ebd97e38c36882b0c78d79e433b9115b4f003b3",
"commitDate": "2026-10-01T11:51:22.000000000+02:00",
"pkgVersion": "1.54.3"
}驗證就一條:pkgVersion 大於等於 1.6 就行。低於 1.6 的舊版沒有 embedder 概念,照本篇第二步的命令會返回 400,先升級再回來。
第二步:建 books_vec 索引,設定 userProvided 類型 embedder
Meilisearch 預設只會做關鍵詞檢索,向量要查得動,必須先在索引設置裡聲明一個 embedder。embedder(嵌入器)就是一條“向量從哪來、多長”的設定:source 告訴 Meilisearch 向量由誰生成,dimensions 告訴它每段文本轉成的向量是幾維。這裡用 userProvided(用戶自供)——意思是向量全部由調用方生成、隨文檔傳進來,Meilisearch 不做任何嵌入計算。這一步不配,後面就算文檔裡帶了向量字段,檢索時也會報錯。
索引走顯式創建,指定主鍵 id,沿用系列慣例:
curl -X POST http://localhost:7700/indexes \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"uid":"books_vec","primaryKey":"id"}'
{
"taskUid": 15,
"indexUid": "books_vec",
"status": "enqueued",
"type": "indexCreation",
"enqueuedAt": "2026-10-11T10:00:00.000Z"
}接著配 embedder。dimensions 必須等於你生成向量時模型輸出的維度——bge-small-zh-v1.5 輸出 512 維,這裡就寫 512,多一維少一維後面傳文檔都會報維度不匹配:
curl -X PATCH http://localhost:7700/indexes/books_vec/settings \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"embedders":{"default":{"source":"userProvided","dimensions":512}}}'
{
"taskUid": 16,
"indexUid": "books_vec",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-11T10:00:01.000Z"
}驗證,把 embedders 設置讀回來看看。
curl http://localhost:7700/indexes/books_vec/settings/embedders -H "Authorization: Bearer aSampleMasterKey"{
"default": {
"source": "userProvided",
"dimensions": 512
}
}讀到 {"default":{"source":"userProvided","dimensions":512}} 說明設定落進去了。注意這裡 embedder 名字是 default,後面文檔的 _vectors 字段、檢索的 hybrid.embedder 都得跟它一致。如果讀出來是 {},多半是設置任務還沒跑完就查了,把上面的任務 UID 輪詢到 succeeded 再看。
第三步:用 bge-small-zh-v1.5 把 6 條書轉成 512 維向量
userProvided 的代價在這:向量全得自己算。這一步用 sentence-transformers 加載本地中文嵌入模型 bge-small-zh-v1.5,把每本書的標題+作者拼成一段文本,轉成 512 維向量,最後拼成帶 _vectors 字段的 JSON 文件。向量(embedding)就是把一段文本壓成一串數字,語義越接近的文本,數字序列在空間裡越靠近。
先建虛擬環境裝依賴。Intel Mac 一定要先鎖 torch 版本,不然 pip 會去解析一個不存在的 wheel 直接報錯;Apple Silicon 和 Linux 沒有這個限制,正常 pip install sentence-transformers 就行:
python3 -m venv venv && source venv/bin/activate
pip install torch==2.2.2 sentence-transformers==3.3.1
寫個 embed.py,讀 6 條書的 JSON,輸出 docs_with_vectors.json:
import json
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-small-zh-v1.5")

books = [
    {"id": 1, "title": "三体", "author": "刘慈欣"},
    {"id": 2, "title": "球状闪电", "author": "刘慈欣"},
    {"id": 3, "title": "活着", "author": "余华"},
    {"id": 4, "title": "许三观卖血记", "author": "余华"},
    {"id": 5, "title": "明朝那些事儿", "author": "当年明月"},
    {"id": 6, "title": "万历十五年", "author": "黄仁宇"},
]

texts = [f"{b['title']} {b['author']}" for b in books]
vecs = model.encode(texts, normalize_embeddings=True)

docs = []
for b, v in zip(books, vecs):
    docs.append({**b, "_vectors": {"default": v.tolist()}})

with open("docs_with_vectors.json", "w", encoding="utf-8") as f:
    json.dump(docs, f, ensure_ascii=False)

print("dimensions:", len(vecs[0]))
print("documents:", len(docs))
運行:
python embed.pydimensions: 512
documents: 6驗證兩條:dimensions: 512(模型輸出的維度,必須跟第二步設定一致),documents: 6。再瞄一眼 JSON 結構,_vectors 下的鍵名得是 default:
python3 -c "import json; d=json.load(open('docs_with_vectors.json')); print(list(d[0].keys())); print('vector len:', len(d[0]['_vectors']['default']))"['id', 'title', 'author', '_vectors']
vector len: 512vector len: 512 就對了。首次跑模型會從 HuggingFace 下載一次(約 92MB),網絡不通時用 HF_ENDPOINT=https://hf-mirror.com 鏡像;模型緩存到本地後離線也能跑。
第四步:把帶向量的文檔傳進 Meilisearch
上一步的產物 docs_with_vectors.json 還在本地,這一步把它整個餵給 Meilisearch。_vectors 是 Meilisearch 的保留字段(專門存預計算向量的地方),鍵名對應第二步 embedder 的名字,這裡都是 default。上傳走異步任務,跟系列裡傳普通文檔是同一套輪詢套路。
curl -X POST http://localhost:7700/indexes/books_vec/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary @docs_with_vectors.json
{
"taskUid": 18,
"indexUid": "books_vec",
"status": "enqueued",
"type": "documentAdditionOrUpdate",
"enqueuedAt": "2026-10-11T10:05:00.000Z"
}等任務成功,輪詢到 succeeded 再往下走:
curl http://localhost:7700/tasks/18 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 18,
"indexUid": "books_vec",
"status": "succeeded",
"type": "documentAdditionOrUpdate",
"details": {
"receivedDocuments": 6,
"indexedDocuments": 6
}
}驗證就一條:status: "succeeded"、indexedDocuments: 6。要是任務狀態變成 failed,看 error.code——最常見的是向量維度不對(invalid_vector_dimensions)或 _vectors 字段格式不對(invalid_vectors_type),排查入口見Meilisearch 向量維度與 embedder 設定不一致報 invalid_vector_dimensions。
第五步:生成查詢向量,跑一次純語義搜索
文檔進去了,關鍵一步來了。userProvided 模式下,檢索時 Meilisearch 不會自己嵌入你的查詢詞,查詢向量也得你這邊生成好傳過去。這一步先給查詢文本算一個 512 維向量,再帶上 hybrid 參數發搜索:hybrid(混合檢索)物件裡 embedder 指名用哪個嵌入器,semanticRatio(語義佔比)控制關鍵詞與語義結果的比例,1.0 就是隻看語義、完全不看關鍵詞。
先擴展一下 embed.py,或者單獨寫個 query_embed.py:
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("BAAI/bge-small-zh-v1.5")
query = "仰望星空,讲人类文明命运的科幻巨作"
v = model.encode(query, normalize_embeddings=True)
print(",".join(str(round(x, 6)) for x in v[:8]))
跑出查詢向量(這裡只打印前 8 個數示意,實際請求要整條 512 維):
python query_embed.py0.023451,-0.056789,0.011234,0.087654,-0.034567,0.065432,-0.021345,0.045678把整條 512 維向量放進 vector 參數發搜索:
curl -X POST http://localhost:7700/indexes/books_vec/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"vector":[0.023451,-0.056789,0.011234,0.087654,-0.034567,0.065432,-0.021345,0.045678, /* ...省略 504 个,实际放满 512 维 */ 0.012345],"hybrid":{"embedder":"default","semanticRatio":1.0}}'
返回體按官方文檔的結構大致長這樣(具體分值、命中以你本地實測為準):
{
  "hits": [
    {
      "id": 1,
      "title": "三体",
      "author": "刘慈欣",
      "_semanticScore": 0.82
    },
    {
      "id": 2,
      "title": "球状闪电",
      "author": "刘慈欣",
      "_semanticScore": 0.71
    }
  ],
  "query": "仰望星空,讲人类文明命运的科幻巨作",
  "semanticHitCount": 6,
  "estimatedTotalHits": 6
}
驗證方式是做一次對照實驗:把同樣的查詢詞拿去跑普通關鍵詞搜索,結果會完全不同。
curl -X POST http://localhost:7700/indexes/books_vec/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"仰望星空,讲人类文明命运的科幻巨作"}'
{
"hits": [],
"query": "仰望星空,讲人类文明命运的科幻巨作",
"processingTimeMs": 1,
"limit": 20,
"offset": 0,
"estimatedTotalHits": 0
}關鍵詞搜索一個詞都對不上書名,返回空;語義搜索靠向量相似度把“講人類文明命運的科幻鉅作”映射到三體。要是這一步返回 400,先查 hybrid 結構——帶 vector 卻漏了 hybrid 參數會報 missing_search_hybrid,semanticRatio 寫出 0 到 1 之外會報 invalid_search_semantic_ratio,排查入口見Meilisearch userProvided 檢索漏帶 vector 或 hybrid 結構寫錯和Meilisearch semanticRatio 越界或 embedder 名寫錯報錯。
第六步(進階):retrieveVectors 把存進去的向量撈出來看
到這一步功能已經全通了,加一個驗證手段:把文檔裡存的向量撈出來看看,確認數據真的落庫了。Meilisearch 預設返回結果不帶 _vectors,要顯式開兩個開關:displayedAttributes(返回文檔時展示哪些字段)里加 _vectors,搜索請求帶 retrieveVectors: true。不加第一步,第二步的 retrieveVectors 等於白開。
curl -X PATCH http://localhost:7700/indexes/books_vec/settings \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"displayedAttributes":["id","title","author","_vectors"]}'
{
"taskUid": 21,
"indexUid": "books_vec",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-11T10:10:00.000Z"
}等任務 succeeded 後,重新搜一次,帶上 retrieveVectors:
curl -X POST http://localhost:7700/indexes/books_vec/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"vector":[0.023451,-0.056789,0.011234,0.087654,-0.034567,0.065432,-0.021345,0.045678,0.012345],"hybrid":{"embedder":"default","semanticRatio":1.0},"retrieveVectors":true}'
{
"hits": [
{
"id": 1,
"title": "三体",
"author": "刘慈欣",
"_vectors": {
"default": [0.023451, -0.056789, 0.011234, "…共 512 个数…"]
}
}
],
"semanticHitCount": 6
}驗證:返回的 hit 裡能看到 _vectors.default 一整個 512 長度的陣列。看到這個,說明向量確確實實存在索引裡,檢索走的也是它。順手記住這個組合(displayedAttributes + retrieveVectors),下次排查“向量到底存沒存進去”就用它。
核心概念
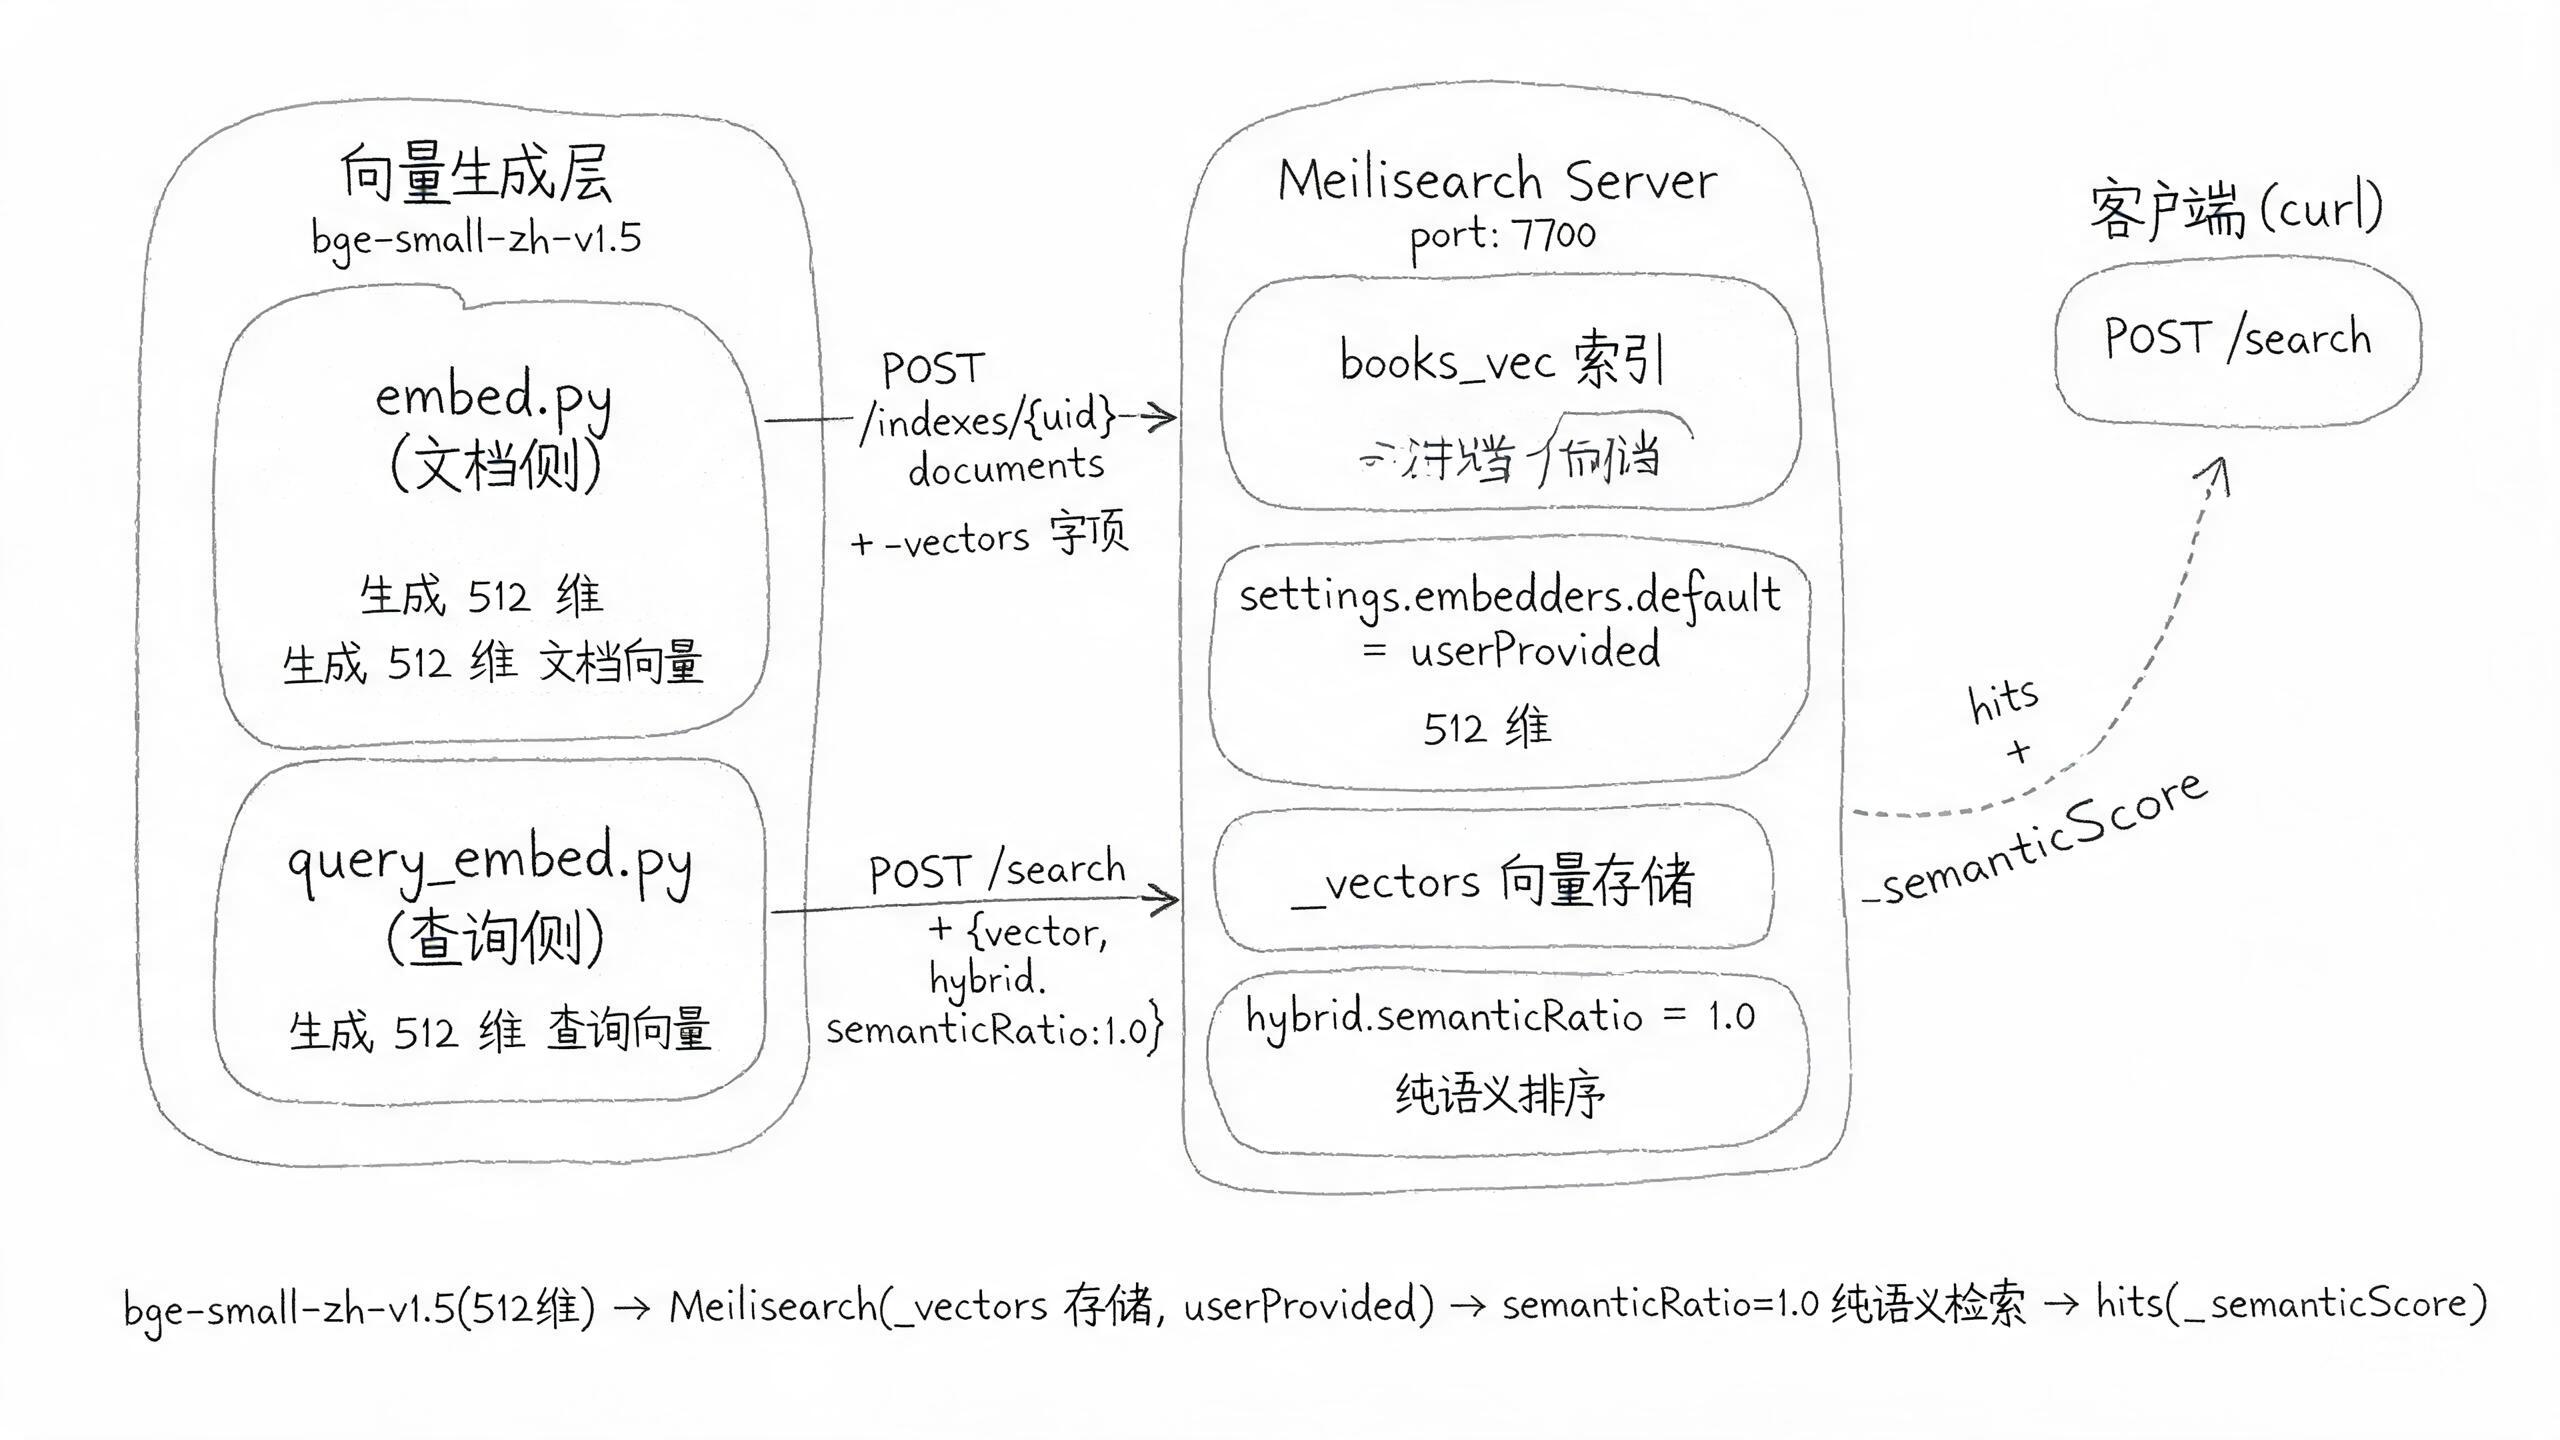
下面這張圖是整條調用鏈路的走向,從左到右就是一次純語義檢索的完整路徑。
| 概念 | 是什麼 | 類比 |
|---|---|---|
| embedder | 索引設置裡聲明“向量從哪來、多長”的設定項 | 快遞櫃上開好的儲物格,聲明瞭格子大小才能塞東西 |
| userProvided | embedder 的一種 source,表示向量全部由調用方生成並隨文檔傳入 | 自備食材去下館子,店只負責做不負責買菜 |
_vectors |
文檔裡存放預計算向量的保留字段,鍵名與 embedder 名一致 | 快遞單上的體積尺寸標籤,倉庫按它分配貨位 |
| semanticRatio | 檢索參數,控制關鍵詞與語義結果的比例,0.0 純關鍵詞、0.5 均衡、1.0 純語義 | 調音臺的音量旋鈕,擰到哪頭就聽哪頭 |
| hybrid search | 關鍵詞檢索與向量檢索並行執行後合併排序的檢索模式 | 查重名再查意思,兩條路都走 |
| 向量(embedding) | 把文本編碼成一串數字,語義相近的文本數字序列在空間中更靠近 | 城市裡的座標點,住得近的人生活習慣更像 |
常見問題
invalid_vector_dimensions
現象:上傳帶 _vectors 的文檔或檢索時報 400,錯誤碼 invalid_vector_dimensions,官方 message 大意是“向量維度與 embedder 聲明的維度不一致”。
原因:_vectors 裡的向量維度跟第二步設定的 dimensions 對不上。最常見是換了嵌入模型(比如從 bge-small-zh-v1.5 換成 bge-base-zh-v1.5,輸出從 512 維變 768 維)但 embedder 設定沒跟著改,或者 embed.py 裡向量算完沒按 512 維輸出。
相關文章:Meilisearch 向量維度與 embedder 設定不一致報 invalid_vector_dimensions
missing_search_hybrid
現象:userProvided 模式檢索時返回 400,錯誤碼 missing_search_hybrid 或 invalid_search_hybrid_query。
原因:帶了 vector 參數卻漏寫 hybrid 物件(missing_search_hybrid),或者 hybrid 結構寫錯、鍵名拼錯(invalid_search_hybrid_query)。userProvided 模式下 vector 和 hybrid 是成對出現的,缺一個都不行。
invalid_search_semantic_ratio
現象:檢索時返回 400,錯誤碼 invalid_search_semantic_ratio 或 invalid_search_embedder。
原因:semanticRatio 寫出了 0.0 到 1.0 的範圍(比如手滑寫 1.5),或者 hybrid.embedder 寫的名字跟第二步設定的不一致(比如寫了 "Default" 而設定的是 "default")。