
跟著這篇走完,你會在本地把 Meilisearch 的拼寫容錯(typo tolerance)跑通:先看預設設定下拼錯單詞能不能搜到結果,再把容錯閾值擰鬆擰緊觀察命中變化,最後用 disableOnWords、enabled 把容錯定向關掉,親眼看到“拼寫容錯到底在什麼時候幫了你、什麼時候反而礙事”。整個過程 6 步,每步都有一條命令能驗證自己做對了沒有。localhost:7700 是 Meilisearch 的預設監聽地址,master key 固定用 aSampleMasterKey,索引建新的 books_typo——你要是換了端口、key 或索引名,把示例值替換掉就行。這篇預設你已經裝好並跑通了從零跑通 Meilisearch 本地搜索服務,安裝、啟動、異步任務輪詢的套路全部複用第一篇。跟系列其他篇的區別說在前面:這一篇不碰向量、不碰過濾,只玩拼錯能不能搜到這一件事,索引數據裡我加了 title_en(英文書名)字段——中文按詞典切出來的詞多是 1–2 個字的短詞,按容錯規則幾乎沒有容錯空間,用英文書名演示才看得清閾值變化。
前置條件
| 項 | 要求 | 說明 |
|---|---|---|
| Meilisearch | v1.54.3 或更高 | typo tolerance 是長期穩定特性;v1.45 起改設置不再觸發全量重索引,行為與老版本有差異 |
| 前置文章 | 已跑通 meilisearch-local-search |
複用其安裝/啟動/master key/異步任務輪詢套路;沒跑通先回去補 |
| curl | 任意版本 | 全文用 curl 調 REST API |
先跑這條,確認第一篇的服務還活著。
curl http://localhost:7700/health{
"status": "available"
}返回 {"status":"available"} 就滿足條件。要是返回 curl: (7) Failed to connect to localhost port 7700,說明服務沒起——回第一篇第一步用 meilisearch --master-key="aSampleMasterKey" 重新啟動,再回來。
第一步:建 books_typo 索引,傳 6 本帶英文書名的書
容錯要發生在“已索引的詞”和“查詢詞”之間,所以第一步先把索引和數據準備好。索引走顯式創建,指定主鍵 id,沿用系列慣例:
curl -X POST http://localhost:7700/indexes \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"uid":"books_typo","primaryKey":"id"}'
{
"taskUid": 50,
"indexUid": "books_typo",
"status": "enqueued",
"type": "indexCreation",
"enqueuedAt": "2026-10-13T10:00:00.000Z"
}接著傳 6 本書。字段有 id、title、author、summary,外加系列其他篇沒有的 title_en(英文書名,後面所有拼錯演示都打在它身上):
curl -X POST http://localhost:7700/indexes/books_typo/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '[
    {"id":1,"title":"三体","author":"刘慈欣","summary":"仰望星空,写人类文明与三体文明星际博弈的科幻巨作","title_en":"The Three-Body Problem"},
    {"id":2,"title":"球状闪电","author":"刘慈欣","summary":"以球状闪电为引的科幻小说,物理奇观与人生选择","title_en":"Ball Lightning"},
    {"id":3,"title":"活着","author":"余华","summary":"写普通人在苦难中活下去的故事,农村家庭的伦理与温情","title_en":"To Live"},
    {"id":4,"title":"许三观卖血记","author":"余华","summary":"写小人物靠卖血养家的故事,底层生活的坚韧与荒诞","title_en":"Chronicle of a Blood Merchant"},
    {"id":5,"title":"明朝那些事儿","author":"当年明月","summary":"用通俗笔法写明朝三百年历史,官场斗争与王朝兴衰","title_en":"The Ming Dynasty Story"},
    {"id":6,"title":"万历十五年","author":"黄仁宇","summary":"从万历十五年切入,剖析明朝制度的运转与深层困境","title_en":"1587, A Year of No Significance"}
  ]'
{
"taskUid": 51,
"indexUid": "books_typo",
"status": "enqueued",
"type": "documentAdditionOrUpdate",
"enqueuedAt": "2026-10-13T10:01:00.000Z"
}上傳是異步的,任務跑完才落庫。等 taskUid: 51 變成 succeeded:
curl http://localhost:7700/tasks/51 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 51,
"indexUid": "books_typo",
"status": "succeeded",
"type": "documentAdditionOrUpdate",
"details": {
"receivedDocuments": 6,
"indexedDocuments": 6
}
}看到 indexedDocuments: 6 就說明 6 條都落庫了。搜一個正確拼寫確認基線——problem 是《三體》英文書名裡 The Three-Body Problem 的詞:
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"problem"}'
{
"hits": [
{
"id": 1,
"title": "三体",
"title_en": "The Three-Body Problem"
}
],
"query": "problem",
"processingTimeMs": 2,
"estimatedTotalHits": 1
}命中《三體》就對了。這一步只是基線,接下來才看容錯。
第二步:拼錯一個字母,預設設定下照樣搜到
現在關鍵問題來了:搜錯字會怎樣。拼寫容錯(typo tolerance)是 Meilisearch 預設開啟的檢索特性——查詢詞和索引裡的詞有少量出入時,仍然能匹配到正確的詞條。它內部用 Damerau-Levenshtein 距離計算“錯幾個字母”,再按詞的字符數給不同的容錯預算(後面第三步講分檔)。注意它不會給你“你是不是想找 problem?“這類拼寫建議(沒有 did-you-mean),只是讓錯拼的結果也能搜到。
搜索 problam(problem 第 6 個字母 e 打成 a,1 個錯字):
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"problam","showRankingScore":true}'
{
"hits": [
{
"id": 1,
"title": "三体",
"title_en": "The Three-Body Problem",
"_rankingScore": 0.81
}
],
"query": "problam",
"processingTimeMs": 2,
"estimatedTotalHits": 1
}problam 照樣命中《三體》。這裡 showRankingScore: true 讓每條結果帶上 _rankingScore(相關性分數,0.0 到 1.0,越高越相關)——它小於精確匹配的分值,說明這次是帶著 1 個錯字匹配上的。預設設定下這類單字母拼錯是被容忍的,什麼都不用配。
驗證這一步成立:把容錯關掉的命令還沒用上,但可以先讀一下當前設置,確認它確實是預設開的。
curl http://localhost:7700/indexes/books_typo/settings/typo-tolerance -H "Authorization: Bearer aSampleMasterKey"{
"enabled": true,
"minWordSizeForTypos": {
"oneTypo": 5,
"twoTypos": 9
},
"disableOnWords": [],
"disableOnAttributes": []
}enabled: true 就對了,這就是 typo tolerance 的預設設置物件。字段含義:enabled 總開關;minWordSizeForTypos 容錯分檔閾值;disableOnWords / disableOnAttributes 定向關閉開關(第五步用)。
第三步:閾值分檔——詞越短,容錯越吝嗇
預設的 oneTypo: 5, twoTypos: 9 意思是:1–4 字符的詞允許 0 個錯字;5–8 字符的詞允許 1 個錯字;9 字符及以上的詞允許 2 個錯字,每個詞最多 2 個錯字。另外兩條規則記一下:首字符錯字按 2 個錯字計(防止只差第一個字母的假命中),相鄰兩字母交換位置(如 teh → the)只算 1 個錯字。
拿兩個查詢對照就懂了。先搜 livi——live 第 4 個字母 e 打成 i,1 個錯字,但詞只有 4 個字符,按規則 0 容錯:
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"livi"}'
{
"hits": [],
"query": "livi",
"processingTimeMs": 1,
"estimatedTotalHits": 0
}4 字符的詞錯 1 個字母搜不到。再搜 lighning——lightning(Ball Lightning 裡的詞)少了個 t,8 個字符,有 1 個錯字預算:
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"lighning"}'
{
"hits": [
{
"id": 2,
"title": "球状闪电",
"title_en": "Ball Lightning"
}
],
"query": "lighning",
"processingTimeMs": 2,
"estimatedTotalHits": 1
}同樣錯 1 個字母,8 字符的詞能容忍,4 字符的詞不行——這就是 oneTypo: 5 的邊界。再補充一條規則對首字符的懲罰:比如搜 ding(ming 首字母 d 換成 m),4 字符 0 容錯之外,首字符錯字本身還按 2 個錯字計,雙重不滿足,搜不到。
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"ding"}'
{
"hits": [],
"query": "ding",
"processingTimeMs": 1,
"estimatedTotalHits": 0
}這裡順帶解釋一個容易誤解的點:容錯只作用在分詞後的詞上,不是原始字符串。Meilisearch 的解析器 Charabia 先按語言把文本切詞(英文按空格切、中文按詞典切),容錯計算發生在詞和詞之間。所以中文查詢幾乎不吃這層容錯——中文詞大多是 1–2 個字的短詞,按上面的分檔 0 容錯,這就是為什麼這篇要用 title_en 演示。驗證這三條查詢的輸出:livi 和 ding 返回空、lighning 命中《球狀閃電》,就說明你理解了分檔規則。
第四步:PATCH 調閾值,驗證改動真生效
預設的 oneTypo: 5 擋住了 4 字符詞的 1 個錯字。現在把它擰到 4,讓 4 字符詞也享受 1 個錯字預算,然後搜剛才失敗的 livi——如果改動生效,這次應該能命中《活著》。
設定端點用 PATCH(不是 PUT):PATCH /indexes/books_typo/settings/typo-tolerance,只改 minWordSizeForTypos。
curl -X PATCH http://localhost:7700/indexes/books_typo/settings/typo-tolerance \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"minWordSizeForTypos":{"oneTypo":4,"twoTypos":9}}'
{
"taskUid": 52,
"indexUid": "books_typo",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-13T10:10:00.000Z"
}設置更新同樣是異步任務,返回 202 + taskUid,等它 succeeded 再驗證:
curl http://localhost:7700/tasks/52 -H "Authorization: Bearer aSampleMasterKey"{
"uid": 52,
"indexUid": "books_typo",
"status": "succeeded",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-13T10:10:00.000Z",
"startedAt": "2026-10-13T10:10:00.200Z",
"finishedAt": "2026-10-13T10:10:00.400Z"
}再搜 livi:
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"livi"}'
{
"hits": [
{
"id": 3,
"title": "活着",
"title_en": "To Live"
}
],
"query": "livi",
"processingTimeMs": 2,
"estimatedTotalHits": 1
}第三步搜不到、第四步搜到了——閾值改動真實生效。這裡有個版本差異值得知道:v1.45 之前改 typo tolerance 設置會觸發全量重索引(數據量大時要等很久);v1.45(2026-05-26)起 typo tolerance 設置改動免重索引,v1.46 起 disableOnWords 等也免。你本地是 v1.54.3,上面這個任務幾百毫秒就完成了,就是免重索引的結果。驗證:livi 從空命中變成命中《活著》,第四步就成立了。
第五步:disableOnWords / disableOnAttributes 定向關閉容錯
閾值分檔是“全局”的容錯預算。有些詞我們希望永遠精確匹配——品牌名、型號、程式碼這類詞,錯一個字母就不該搜到。disableOnWords 就是幹這個的:指定哪些查詢詞不吃容錯。
把 problem 加進 disableOnWords,再搜剛才能命中的 problam:
curl -X PATCH http://localhost:7700/indexes/books_typo/settings/typo-tolerance \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"disableOnWords":["problem"]}'
{
"taskUid": 53,
"indexUid": "books_typo",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-13T10:15:00.000Z"
}等任務 succeeded(輪詢 GET /tasks/53,套路同第四步),再搜:
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"problam"}'
{
"hits": [],
"query": "problam",
"processingTimeMs": 1,
"estimatedTotalHits": 0
}problem 被放進禁用名單後,problam 搜不到了。精確拼寫不受影響,problem 本身照樣能搜到《三體》。對照一下:第四步改的是“容錯預算多給一點”,這一步是“某個詞完全不給容錯”——兩種需求對應兩個不同開關。
disableOnAttributes 是按字段關:指定某個字段名後,查這個詞時對該字段裡的內容不做容錯匹配。適合 SKU、條碼這類存數字字母串的字段。用法一樣,{"disableOnAttributes":["title_en"]} 就把整個 title_en 字段的容錯關掉。
驗證這一步:problam 從命中變空、problem 仍命中。要是你把 disableOnWords 傳成 ["Problem"] 這種帶大小寫的寫法沒生效,見常見問題第 3 條。
第六步:enabled:false 整體關閉,再重置回預設
最後一個開關是 enabled——整個索引的容錯總閘。把第五步的 disableOnWords 恢復為空(傳空陣列),再關掉 enabled,這樣就能純粹看到“關閉容錯”的效果:
curl -X PATCH http://localhost:7700/indexes/books_typo/settings/typo-tolerance \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"disableOnWords":[],"enabled":false}'
{
"taskUid": 54,
"indexUid": "books_typo",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-13T10:20:00.000Z"
}等 taskUid: 54 變成 succeeded,把第二步和第三步的錯拼查詢都跑一遍——這次一個都不該命中:
curl -X POST http://localhost:7700/indexes/books_typo/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"problam"}'
{
"hits": [],
"query": "problam",
"processingTimeMs": 1,
"estimatedTotalHits": 0
}curl -X POST http://localhost:7700/indexes/books_typo/search \
-H "Authorization: Bearer aSampleMasterKey" \
-H "Content-Type: application/json" \
-d '{"q":"lighning"}'{
"hits": [],
"query": "lighning",
"processingTimeMs": 1,
"estimatedTotalHits": 0
}enabled: false 之後錯拼查詢全軍覆沒。最後把它重置回預設——PATCH 傳 null 表示“恢復該設置的預設值”:
curl -X PATCH http://localhost:7700/indexes/books_typo/settings/typo-tolerance \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d 'null'
{
"taskUid": 55,
"indexUid": "books_typo",
"status": "enqueued",
"type": "settingsUpdate",
"enqueuedAt": "2026-10-13T10:25:00.000Z"
}等任務完成後讀設置,確認回到預設:
curl http://localhost:7700/indexes/books_typo/settings/typo-tolerance -H "Authorization: Bearer aSampleMasterKey"{
"enabled": true,
"minWordSizeForTypos": {
"oneTypo": 5,
"twoTypos": 9
},
"disableOnWords": [],
"disableOnAttributes": []
}看到 enabled: true 和 oneTypo: 5 就完成了重置,problam 也恢復了命中。到這裡你手上已經有三套旋鈕:分檔閾值(第四步)、定向關閉(第五步)、總開關(第六步)——按“寬鬆 / 精確 / 關閉”三個方向都能控住容錯。
核心概念
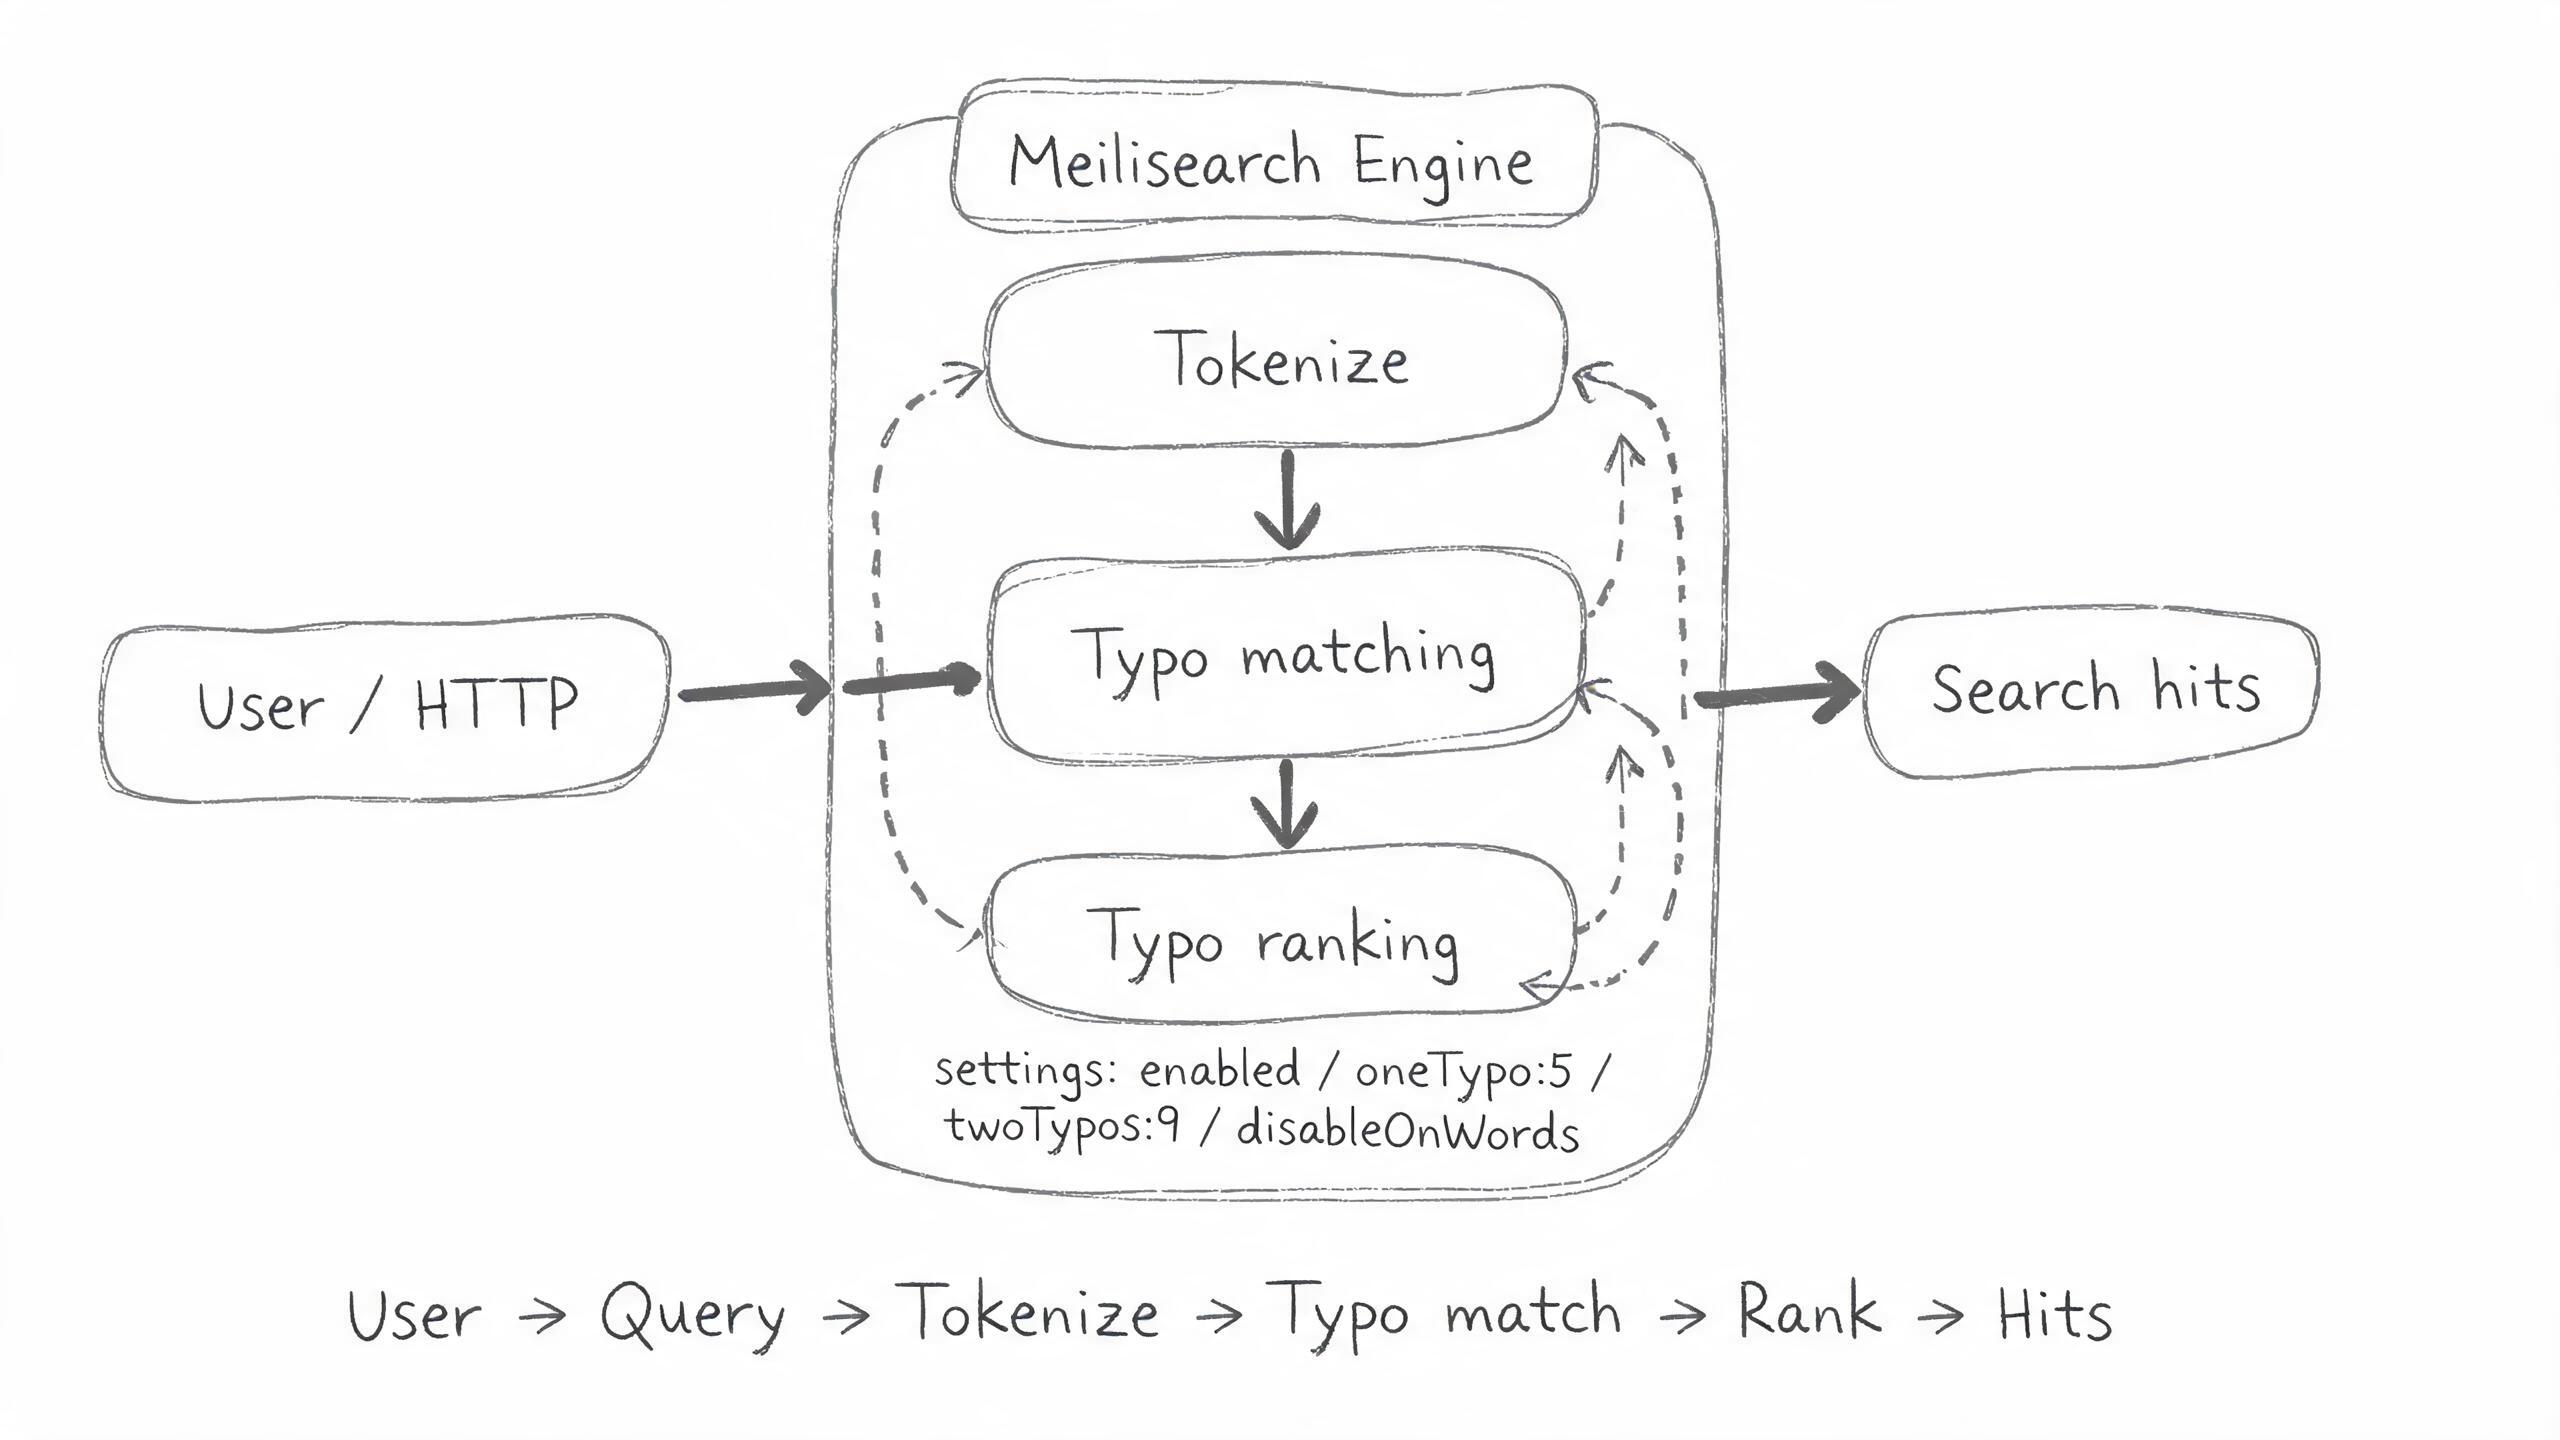
下面這張圖是拼寫容錯在一次查詢裡的位置:查詢詞先被分詞,再與索引裡的詞做容錯距離匹配,命中的文檔按排序規則(其中就有 typo 這條)排出順序。
| 概念 | 是什麼 | 類比 |
|---|---|---|
| typo tolerance(拼寫容錯) | 查詢詞拼寫有出入時仍能匹配到正確詞條的機制,預設開啟 | 輸入法把打錯的拼音自動糾正成正確候選 |
| minWordSizeForTypos | 按詞長分檔的容錯預算:詞越長允許的錯字越多 | 生僻字查字典時,筆畫多的字允許多錯一筆 |
| ranking rule(排序規則) | typo 容錯是排序規則而非過濾器——錯拼結果不會被排除,只是排在精確匹配後面 | 考試按卷面分排序,錯別字多的排後面但不取消資格 |
| disableOnWords / disableOnAttributes | 定向關閉:指定查詢詞或字段不吃容錯 | 報菜名必須一字不差,打錯就重說 |
| Charabia 分詞 | 容錯作用在分詞後的詞上,不是原始字符串;中文按詞典切詞,多為短詞 | 先斷句再改錯,句子都斷錯了就無從談改錯 |
常見問題
{"message":"Invalid value at \.typoTolerance.minWordSizeForTypos.oneTypo`: value: `1000` is too large … maximum value authorized is `255`“,“code”:“invalid_settings_typo_tolerance”}`
現象:PATCH typo tolerance 設置時返回 400,響應體帶 code 而不是 taskUid。
原因:oneTypo / twoTypos 在服務端是 u8 類型,只能取 0–255;且 twoTypos 必須大於 oneTypo。這類字段校驗在請求階段同步報錯,不會生成異步任務。
相關文章:Meilisearch 設定 typo tolerance 報 invalid_settings_typo_tolerance
PATCH 改完設置立刻搜索,結果還是舊行為
現象:第四步那種改閾值操作後馬上搜,命中結果和改之前一模一樣。
原因:設置更新是異步任務,PATCH 只代表任務入隊(返回 taskUid),要輪詢 GET /tasks/{taskUid} 到 succeeded 才生效——和文檔上傳是同一套機制。
中文查詢錯字幾乎搜不到 / disableOnWords 寫了大寫不生效
現象:搜中文錯字(如把“三體”打成“三休”)返回空;disableOnWords 傳 ["Problem"] 卻還能容錯命中。
原因:中文按詞典切詞後多是 1–2 字短詞,按分檔 0 容錯;分詞/詞典的歸一化不覆蓋所有情況,禁用詞需按索引裡的實際形態逐個枚舉。