
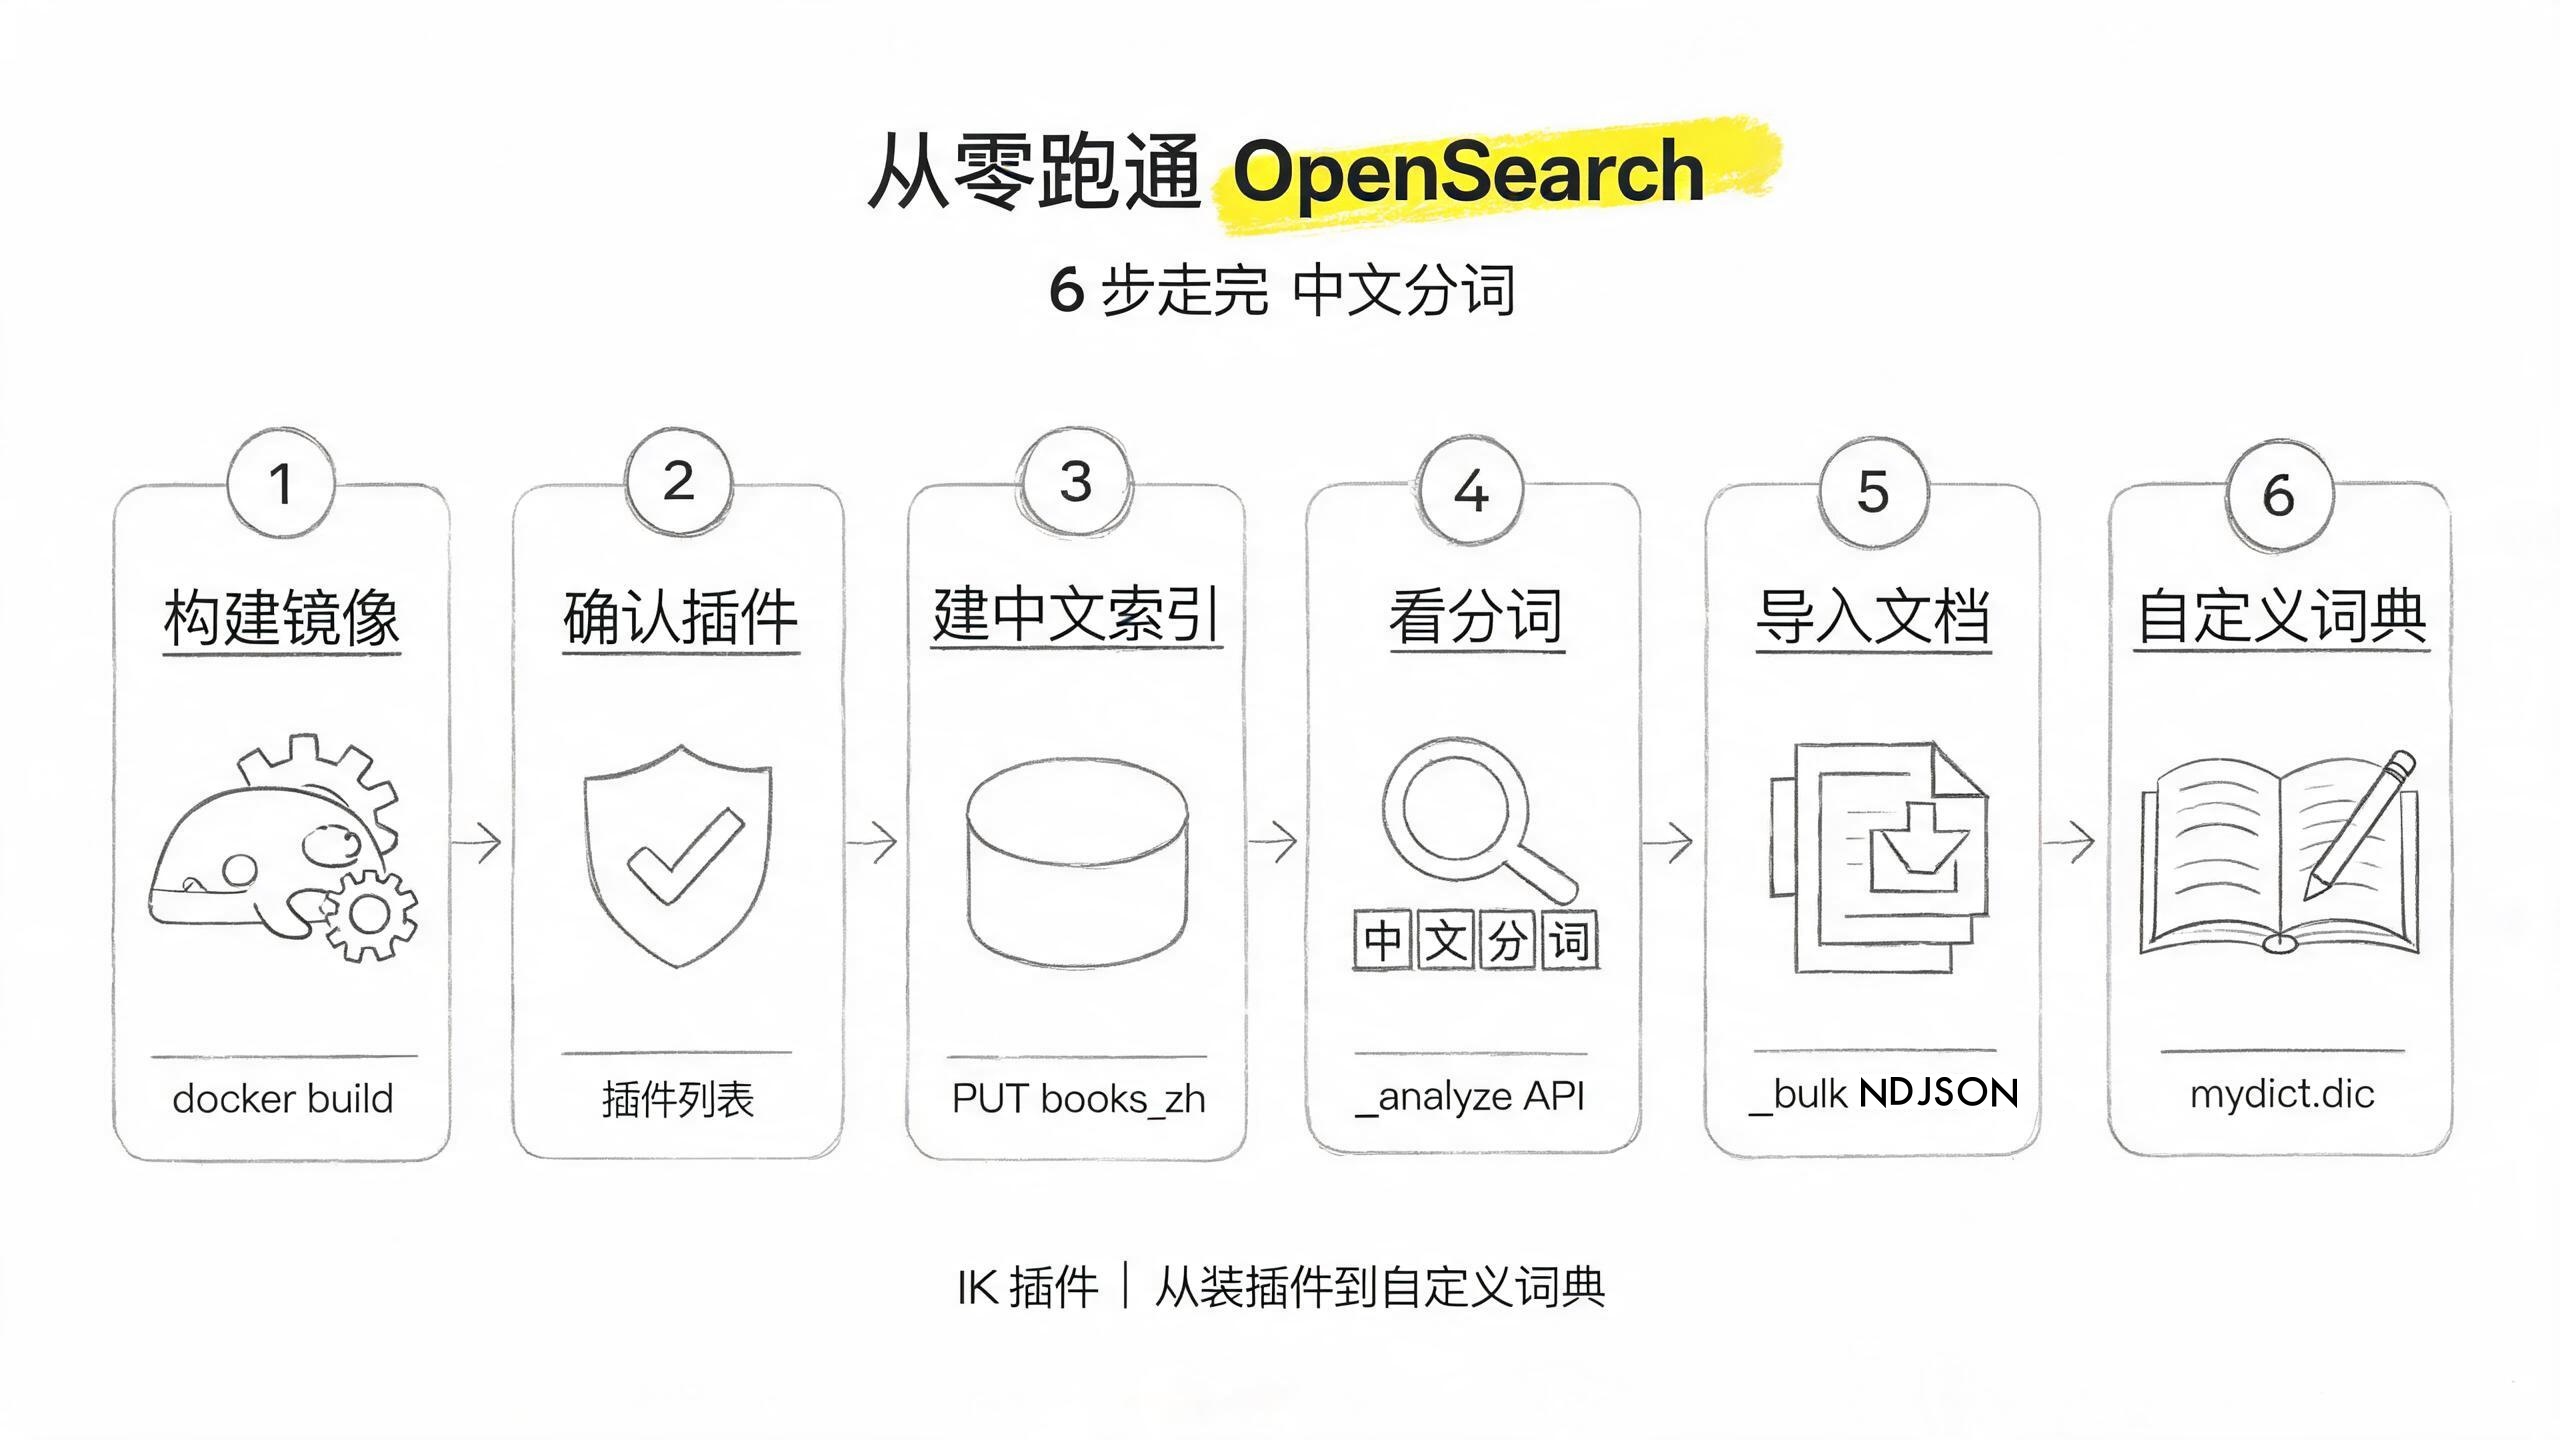
跟著這篇走完,你會在本機用一個帶 IK 插件的 OpenSearch Docker 容器跑起中文搜索:看懂 ik_max_word 和 ik_smart 兩種分析器怎麼把同一句中文切成完全不同的結果,再用自定義詞典把「三體」這類領域專名鎖成整詞。整個過程 6 步,每步都有一條命令能驗證自己做對了沒有。
文中固定用這些值:端口 9200、用戶 admin、示例密碼 Devfix@2026、索引 books_zh、OpenSearch 版本 2.19.0;你換了就把示例值替換掉。這篇預設你已經跑通了從零跑通 OpenSearch 本地搜索服務,Docker 啟動、索引 CRUD、standard 分析器的行為全部複用第一篇,沒跑通先回去把服務起了再回來。
有一點得先說清楚:IK 不是 OpenSearch 內置插件。它是 INFINI Labs 維護的第三方插件(GitHub 倉庫),需要自己裝。好消息是裝法很簡單,一個 Dockerfile 就搞定。如果你玩過從零跑通 Meilisearch 中文搜索,這篇的思路類似但解法不同:Meilisearch 用 Charabia + jieba 開箱可用,OpenSearch 用 IK 需要手動裝但分詞粒度更可控。
前置條件
| 項 | 要求 | 說明 |
|---|---|---|
| Docker | 任意近期版本 | 本文用 Docker 起服務,與 local-search 一致 |
| 記憶體 | Docker Desktop 至少 4 GB | OpenSearch 是 JVM 進程,比較吃記憶體 |
| 前置文章 | 已跑通 opensearch-local-search |
本文複用其 Docker 啟動套路和密碼設置;沒跑通先回去補 |
| curl | 任意版本 | 全文用 curl 調 REST API |
| 磁盤 | 2 GB 以上空閒 | 自定義鏡像 + 索引數據的餘量 |
先確認上一篇的容器還在跑(如果已經停了,後面第一步會重新構建鏡像啟動):
docker ps如果看到 opensearchproject/opensearch 的容器在運行,先停掉它——後面要用自定義鏡像替換:
docker stop <容器ID>第一步:構建帶 IK 插件的 Docker 鏡像
IK 插件沒有現成的 Docker 鏡像,需要自己構建。先創建一個工作目錄,在裡面寫一個 Dockerfile:
mkdir -p opensearch-ik && cd opensearch-ik
cat > Dockerfile <<'EOF'
FROM opensearchproject/opensearch:2.19.0
RUN /usr/share/opensearch/bin/opensearch-plugin install --batch \
    https://get.infini.cloud/opensearch/analysis-ik/2.19.0
EOF
這個 Dockerfile 做兩件事:以官方 OpenSearch 2.19.0 鏡像為基礎,然後用 opensearch-plugin install 從 INFINI Labs 的 CDN 下載安裝 IK 插件。--batch 跳過交互式確認。
關鍵決策:插件版本必須與 OpenSearch 版本完全一致。2.19.0 的 OpenSearch 只能裝 2.19.0 的 IK 插件,差一個小版本都可能啟動失敗。INFINI Labs 的發佈頁列出了所有可用版本,找一個和你 OpenSearch 版本完全匹配的。
開始構建:
docker build -t opensearch-with-ik:2.19.0 .構建過程會下載插件和依賴,需要一兩分鐘。看到 Successfully built 和 Successfully tagged opensearch-with-ik:2.19.0 就成了。
驗證鏡像存在:
docker images opensearch-with-ikREPOSITORY TAG IMAGE ID CREATED SIZE
opensearch-with-ik 2.19.0 abc123def456 30 seconds ago 1.2GB看到 opensearch-with-ik 鏡像就在列表裡。如果構建時報 plugin not found 或 404,多半是版本號寫錯了——IK 插件版本必須和 OpenSearch 版本完全一致,見常見問題第 1 項。
第二步:啟動容器,確認 IK 插件已加載
用自定義鏡像啟動容器,啟動參數和 local-search 一致:
docker run -d -p 9200:9200 -p 9600:9600 \
  -e "discovery.type=single-node" \
  -e "OPENSEARCH_INITIAL_ADMIN_PASSWORD=Devfix@2026" \
  --name opensearch-ik \
  opensearch-with-ik:2.19.0
容器起來後 JVM 啟動要幾十秒,等它就緒。驗證服務通了:
curl -sk -u admin:Devfix@2026 "https://localhost:9200"返回歡迎 JSON 就說明服務通了。現在確認 IK 插件已加載:
curl -sk -u admin:Devfix@2026 "https://localhost:9200/_cat/plugins?v"name component version
a937e... analysis-ik 2.19.0看到 analysis-ik 在元件列表裡、版本是 2.19.0,插件就加載成功了。如果這行沒出現,說明插件沒裝成功——回第一步檢查 Dockerfile 和構建日誌。如果容器根本起不來、反覆重啟,多半是插件版本和 OpenSearch 版本不匹配,見常見問題第 1 項。
第三步:創建中文索引 books_zh,指定 IK 分析器
這篇換一套獨立數據集 books_zh,跟 local-search 的 movies 互不干擾。建索引時在 mappings 裡給 title 字段指定 IK 分析器——analyzer 用 ik_max_word(索引時最細切詞),search_analyzer 用 ik_smart(搜索時最粗切詞):
curl -sk -u admin:Devfix@2026 -X PUT "https://localhost:9200/books_zh?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "settings": {
      "index.number_of_shards": 1,
      "index.number_of_replicas": 0
    },
    "mappings": {
      "properties": {
        "title":    { "type": "text", "analyzer": "ik_max_word", "search_analyzer": "ik_smart" },
        "author":   { "type": "keyword" },
        "category": { "type": "keyword" },
        "summary":  { "type": "text", "analyzer": "ik_max_word", "search_analyzer": "ik_smart" }
      }
    }
  }'
{
"acknowledged" : true,
"shards_acknowledged" : true,
"index" : "books_zh"
}analyzer: ik_max_word 告訴 OpenSearch 索引文檔時用 ik_max_word 把文本切到最細;search_analyzer: ik_smart 告訴它搜索查詢時用 ik_smart 切到最粗。這種「索引細切、搜索粗切」是 IK 的經典搭配——索引時切得細,召回率高;搜索時切得粗,精確度高。
驗證 mappings 生效:
curl -sk -u admin:Devfix@2026 "https://localhost:9200/books_zh/_mappings?pretty"返回裡應該能看到 title 字段的 analyzer 是 ik_max_word、search_analyzer 是 ik_smart。如果報 analyzer [ik_max_word] not found,說明 IK 插件沒加載成功——回第二步確認 _cat/plugins 的輸出,見常見問題第 2 項。
第四步:用 _analyze API 看 IK 怎麼切中文
這是全文最重要的一步——不看這步,後面搜出來的結果你無法解釋。
_analyze API 讓你看到分析器實際怎麼切詞。先試 ik_max_word:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/_analyze?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "analyzer": "ik_max_word",
    "text": "中华人民共和国国歌"
  }'
{
"tokens" : [
{ "token" : "中华人民共和国" },
{ "token" : "中华人民" },
{ "token" : "中华" },
{ "token" : "华人" },
{ "token" : "人民共和国" },
{ "token" : "人民" },
{ "token" : "共和国" },
{ "token" : "共和" },
{ "token" : "国歌" }
]
}ik_max_word 會把文本拆到最細——「中華人民共和國國歌」被切成 9 個詞,從最長的「中華人民共和國」到「共和」「國歌」,儘可能窮舉所有有意義的組合。
現在試 ik_smart,同一句文本:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/_analyze?pretty" \
  -H "Content-Type: application/json" \
  -d '{
    "analyzer": "ik_smart",
    "text": "中华人民共和国国歌"
  }'
{
"tokens" : [
{ "token" : "中华人民共和国" },
{ "token" : "国歌" }
]
}ik_smart 只切出 2 個詞——「中華人民共和國」和「國歌」,乾淨利落,不做多餘拆分。
放在一起對比:
| 分析器 | 切詞結果 | 粒度 | 適合場景 |
|---|---|---|---|
ik_max_word |
中華人民共和國, 中華人民, 中華, 華人, 人民共和國, 人民, 共和國, 共和, 國歌 | 最細,窮舉組合 | 索引時:切得細,召回率高 |
ik_smart |
中華人民共和國, 國歌 | 最粗,智能斷詞 | 搜索時:切得粗,精確度高 |
這裡有一個容易搞錯的點:ik_smart 不是 ik_max_word 的子集。看另一個例子就明白了——搜「乒乓球拍」時 ik_smart 可能切成「乒乓球拍」一個詞,而 ik_max_word 切成「乒乓球」「乒乓」「球拍」,兩者的切法完全不同,不是簡單的包含關係。
這就是第三步設置 analyzer: ik_max_word, search_analyzer: ik_smart 的理由:索引時細切,讓「共和國」也能被搜到;搜索時粗切,讓搜「中華人民共和國」時不會匹配到只含「中華」的文檔。
驗證命令就是上面兩條 _analyze。期望輸出:ik_max_word 返回 9 個 token,ik_smart 返回 2 個。如果報 analyzer [ik_max_word] not found,見常見問題第 2 項。
第五步:導入中文文檔,搜索驗證
灌 6 條虛構中文書籍到 books_zh。數據是刻意設計的——後面搜索結果全都能從分詞行為解釋:
cat > books_zh.ndjson <<'EOF'
{ "index": { "_index": "books_zh", "_id": "1" } }
{ "title": "三体", "author": "刘慈欣", "category": "科幻", "summary": "文化大革命如火如荼时,红岸基地向宇宙发出了第一声啼鸣" }
{ "index": { "_index": "books_zh", "_id": "2" } }
{ "title": "平凡的世界", "author": "路遥", "category": "文学", "summary": "中国农村的变革与年轻人的奋斗" }
{ "index": { "_index": "books_zh", "_id": "3" } }
{ "title": "C++ 编程入门", "author": "张伟", "category": "编程", "summary": "从零开始学习 C++ 编程语言" }
{ "index": { "_index": "books_zh", "_id": "4" } }
{ "title": "C# 高级编程", "author": "李娜", "category": "编程", "summary": "深入理解 C# 和 .NET 框架" }
{ "index": { "_index": "books_zh", "_id": "5" } }
{ "title": "冰激凌与夏天", "author": "林小满", "category": "美食", "summary": "夏日甜品的制作与故事" }
{ "index": { "_index": "books_zh", "_id": "6" } }
{ "title": "未来科技简史", "author": "王强", "category": "科普", "summary": "从人工智能到量子计算的发展历程" }
EOF
bulk 導入:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/_bulk?pretty" \
  -H "Content-Type: application/x-ndjson" \
  --data-binary @books_zh.ndjson
響應裡 "errors" : false 就說明全部導入成功。用 count 驗證:
curl -sk -u admin:Devfix@2026 "https://localhost:9200/books_zh/_count?pretty"{
"count" : 6,
"_shards" : { "total" : 1, "successful" : 1, "skipped" : 0, "failed" : 0 }
}count 是 6 就對了。現在搜「三體」:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/books_zh/_search?pretty" \
  -H "Content-Type: application/json" \
  -d '{ "query": { "match": { "title": "三体" } } }'
{
"hits" : {
"total" : { "value" : 1, "relation" : "eq" },
"hits" : [
{ "_id" : "1", "_score" : 0.8630, "_source" : { "title" : "三体", "author" : "刘慈欣" } }
]
}
}命中了。但這裡有個問題值得深挖——用 _analyze 看看「三體」在索引時被切成了什麼:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/_analyze?pretty" \
  -H "Content-Type: application/json" \
  -d '{ "analyzer": "ik_max_word", "text": "三体" }'
{
"tokens" : [
{ "token" : "三体" },
{ "token" : "三" },
{ "token" : "体" }
]
}ik_max_word 把「三體」切成了 3 個 token:「三體」「三」「體」。這是因為 IK 的預設詞典裡恰好有「三體」這個詞(畢竟太出名了),所以能識別成整詞;但同時它也切出了單字「三」和「體」。
換一個 IK 詞典裡沒有的詞試試——比如你公司名「未來科技」:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/_analyze?pretty" \
  -H "Content-Type: application/json" \
  -d '{ "analyzer": "ik_max_word", "text": "未来科技" }'
{
"tokens" : [
{ "token" : "未来" },
{ "token" : "科技" }
]
}「未來科技」被切成了「未來」和「科技」兩個詞——IK 詞典裡沒有這個複合詞。這意味著搜「未來科技」時,查詢串也會被切成「未來」和「科技」,然後分別匹配——雖然能搜到,但「未來科技」作為一個整體的排名權重不如被識別成整詞時高。
怎麼讓 IK 認識「未來科技」這個專名?用自定義詞典。
第六步:加自定義詞典,把專名鎖成整詞
IK 支持自定義詞典——把你領域裡的專名、新詞加進去,IK 就會把它們當整詞識別。做法是:在本地創建一個詞典文件,掛載到容器裡,然後在 IK 設定文件裡引用它。
先創建詞典文件和設定目錄:
mkdir -p ik-config
cat > ik-config/mydict.dic <<'EOF'
未来科技
平凡的世界
冰激凌
EOF
每行一個詞,文件必須 UTF-8 編碼。然後創建 IK 的設定文件 IKAnalyzer.cfg.xml:
cat > ik-config/IKAnalyzer.cfg.xml <<'EOF'
<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE properties SYSTEM "http://java.sun.com/dtd/properties.dtd">
<properties>
  <entry key="ext_dict">mydict.dic</entry>
</properties>
EOF
ext_dict 指向自定義詞典文件名。多個詞典用分號隔開(dict1.dic;dict2.dic)。
現在把設定文件掛載到容器裡。先停掉當前容器,用新的啟動命令重新跑:
docker stop opensearch-ik && docker rm opensearch-ik

docker run -d -p 9200:9200 -p 9600:9600 \
  -e "discovery.type=single-node" \
  -e "OPENSEARCH_INITIAL_ADMIN_PASSWORD=Devfix@2026" \
  --name opensearch-ik \
  -v "$(pwd)/ik-config/IKAnalyzer.cfg.xml:/usr/share/opensearch/plugins/analysis-ik/config/IKAnalyzer.cfg.xml:ro" \
  -v "$(pwd)/ik-config/mydict.dic:/usr/share/opensearch/plugins/analysis-ik/config/mydict.dic:ro" \
  opensearch-with-ik:2.19.0
-v 把本地文件掛載到容器內 IK 插件的 config 目錄。容器啟動後 IK 會自動加載這個設定。
等服務起來(等幾十秒),驗證自定義詞典生效:
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/_analyze?pretty" \
  -H "Content-Type: application/json" \
  -d '{ "analyzer": "ik_max_word", "text": "未来科技" }'
{
"tokens" : [
{ "token" : "未来科技" }
]
}之前「未來科技」被切成「未來」「科技」兩個詞,現在是一個整詞了。自定義詞典生效。
但注意:自定義詞典隻影響新索引的文檔。已有的 books_zh 索引是在加詞典之前建的,分詞結果不會自動更新。要讓新詞典對已有數據生效,需要重建索引(reindex):
curl -sk -u admin:Devfix@2026 -X POST "https://localhost:9200/books_zh/_forcemerge?max_num_segments=1&pretty"或者更徹底的方式——刪掉重建:
curl -sk -u admin:Devfix@2026 -X DELETE "https://localhost:9200/books_zh?pretty"然後重新執行第三步建索引、第五步導入數據。重新導入後,「未來科技」在索引裡就是整詞了。
驗證命令:_analyze 返回「未來科技」一個 token(而不是「未來」「科技」兩個)。如果自定義詞典不生效,多半是文件編碼不是 UTF-8、或者掛載路徑不對,見常見問題第 3 項。
核心概念
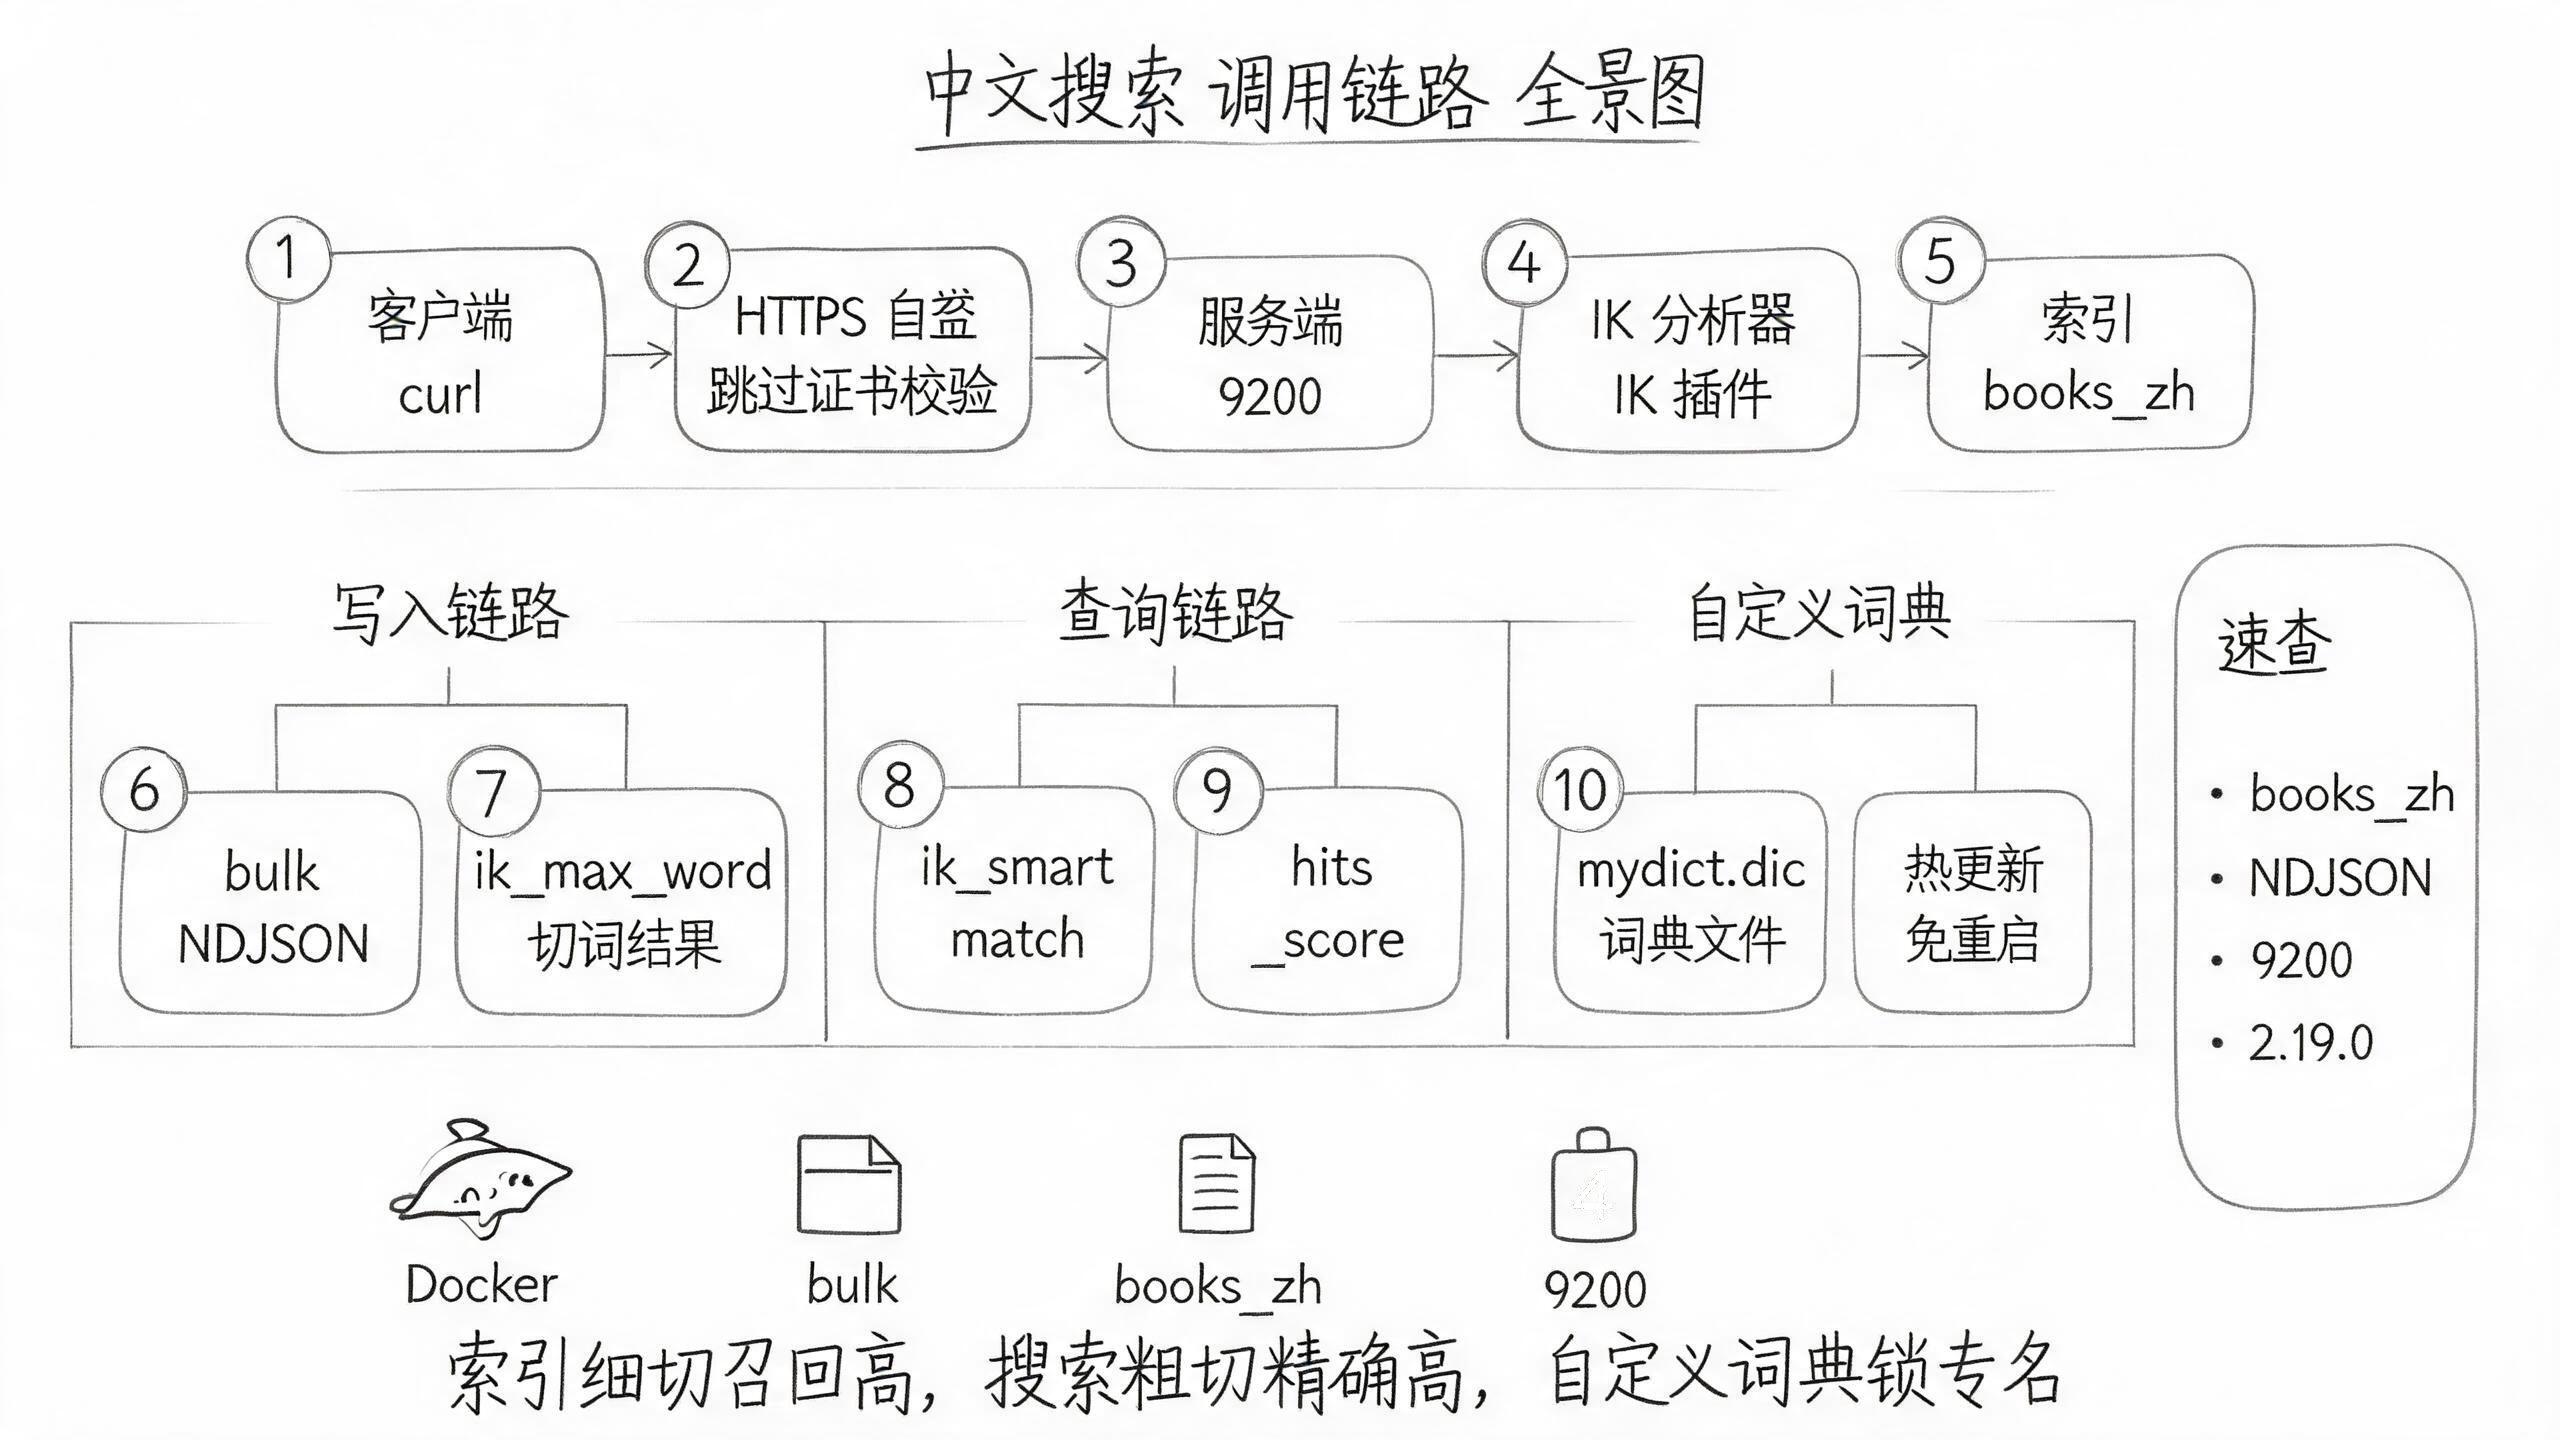
這張全景圖走完就清楚了:寫入路徑是 curl → IK 分析器(ik_max_word 切詞)→ books_zh 索引 → 倒排索引;查詢路徑是查詢串先過 IK 分析器(ik_smart 切詞),再查倒排索引定位文檔。
| 概念 | 是什麼 | 類比 |
|---|---|---|
| IK 分析器 | INFINI Labs 維護的中文分詞插件,集成 Lucene IK 到 OpenSearch | 像給 OpenSearch 裝了一把中文切詞刀 |
ik_max_word |
IK 的最細粒度分析器,窮舉所有可能的詞組合 | 像把一句話拆到不能再拆,確保每個詞都被索引到 |
ik_smart |
IK 的最粗粒度分析器,智能斷詞 | 像讀一句話時只切出最有意義的幾個詞 |
analyzer vs search_analyzer |
索引時用 analyzer 切詞,搜索時用 search_analyzer 切詞 |
索引時細切(多存詞),搜索時粗切(少匹配) |
| 自定義詞典 | 一個 UTF-8 文本文件,每行一個詞,IK 啟動時加載 | 像給詞典補錄你領域裡的專名 |
| 熱更新 | IK 支持通過 HTTP URL 遠程加載詞典,定時輪詢更新 | 像在線詞典,改了服務器上的文件就自動生效 |
常見問題
IK 插件版本與 OpenSearch 不匹配,容器啟動失敗
現象:docker run 後容器反覆重啟,docker logs 裡報 Plugin [analysis-ik] was built for 版本不匹配。
原因:IK 插件版本必須與 OpenSearch 版本完全一致(major.minor.patch)。2.19.0 的 OpenSearch 只能裝 2.19.0 的 IK 插件。INFINI Labs 的發佈頁列出了所有可用版本。
建索引報 analyzer [ik_max_word] not found
現象:PUT /books_zh 時返回 400,錯誤信息含 analyzer [ik_max_word] not found。
原因:IK 插件沒有加載成功。先用 GET /_cat/plugins 確認 analysis-ik 是否在列。如果不在,說明插件沒裝成功或版本不匹配導致加載失敗——回第一步和第二步檢查。
自定義詞典不生效
現象:加了自定義詞典文件,重啟容器後 _analyze 返回的分詞結果沒變化。
原因:三個檢查點——① 詞典文件必須是 UTF-8 編碼(Windows 記事本預設保存的可能是 GBK);② IKAnalyzer.cfg.xml 裡的文件名要和實際文件名完全一致(大小寫敏感);③ 掛載路徑必須是 /usr/share/opensearch/plugins/analysis-ik/config/ 目錄。