
跟著這篇走完,你會在本地把 Meilisearch 的相關度排序看透:預設 7 條排名規則(rankingRules,決定搜索結果先後順序的規則列表)從左到右逐條裁決,你用 showRankingScore 和 showRankingScoreDetails 把每條結果的分數和每條規則的裁決明細都讀出來——「為什麼它排前面」從此有數字可查,最後再用 rankingScoreThreshold 把低分結果整檔切掉。整個過程 7 步,每步都有一條命令能驗證自己做對了沒有。localhost:7700 是 Meilisearch 的預設監聽地址,master key(Meilisearch 的接口訪問密鑰)固定用 aSampleMasterKey,索引建新的 books_rank(還是系列風格的虛構書籍,每本帶 title_en 和 summary 兩個英文字段);你要是換了端口、key 或索引名,把示例值替換掉就行。這篇預設你已經裝好並跑通了從零跑通 Meilisearch 本地搜索服務,安裝、啟動、異步任務輪詢的套路全部複用第一篇。跟系列裡排序與自定義排名那篇的分工說在前面:那篇講「我要按什麼排」——sort 參數怎麼傳、自定義規則怎麼寫;這篇講「預設它按什麼排」——引擎內置的 7 條規則各自裁決什麼、分數怎麼算出來,兩篇拼起來才是完整的排序認知。
前置條件
| 項 | 要求 | 說明 |
|---|---|---|
| Meilisearch | v1.36 或更高 | v1.36 起預設規則從 6 條變 7 條(attribute 拆成 attributeRank + wordPosition),太低照做會踩到規則名單對不上 |
| 前置文章 | 已跑通 meilisearch-local-search |
複用其安裝/啟動/master key/異步任務輪詢套路;沒跑通先回去補 |
| master key | aSampleMasterKey |
與系列一致 |
| curl | 任意版本 | 全文用 curl 調 REST API |
先跑這條,確認第一篇的服務還活著。
curl http://localhost:7700/health{"status":"available"}返回 {"status":"available"} 就滿足條件。要是返回 curl: (7) Failed to connect to localhost port 7700,說明服務沒起——回第一篇第一步用 meilisearch --master-key="aSampleMasterKey" 重新啟動,再回來。
第一步:確認版本,對齊 7 條規則名單
本篇全程圍繞預設排名規則展開,而這個名單在 v1.36 變過一次:舊版 6 條裡的 attribute 一條規則管兩件事(字段權重 + 詞在字段裡的位置),v1.36 起拆成 attributeRank(只管字段權重)和 wordPosition(只管詞位置)兩條。版本不對,你 GET 出來的規則名單就和正文對不上號,後面每一步都會對不上。所以第一步先把版本釘死。
curl http://localhost:7700/version -H "Authorization: Bearer aSampleMasterKey"{"commitSha":"7ebd97e38c36882b0c78d79e433b9115b4f003b3","commitDate":"2026-10-01T11:51:22.000000000+02:00","pkgVersion":"1.54.3"}版本號看 pkgVersion 字段,≥ 1.36 就行。本系列環境是 v1.54.3。
第二步:建 books_rank 索引 + 寫 6 條書 + 看預設規則名單
讀分數要先有數據可讀。這一步搭數據底座:索引 books_rank,6 條虛構書籍。字段設計有個刻意的地方——除了中文書名 title,每本還帶 title_en(英文書名)和 summary(英文摘要)。原因有兩個:中文詞經分詞(把連續文字切成可檢索的詞條)後多是 1–2 字的短詞,演示容錯和詞距看不真切(typo-tolerance 篇用過同款做法);而相關度演示需要「同一個詞命中不同字段」的現場,title_en 和 summary 正好提供兩個字段讓 attributeRank 規則表演。本篇所有演示查詢都用英文詞,避開中文分詞的變數。
索引顯式指定主鍵(每條文檔的唯一標識字段),避免自動推斷翻車:
curl -X POST http://localhost:7700/indexes \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"uid":"books_rank","primaryKey":"id"}'
{
"taskUid": 0,
"indexUid": "books_rank",
"status": "enqueued",
"type": "indexCreation"
}返回的 taskUid 是異步任務編號——Meilisearch 的寫入和設置操作都是後臺任務,得輪詢到 succeeded 才算完,套路複用第一篇。全新環境任務號從 0 開始;要是你的環境已經跑過系列前幾篇,以實際返回的 taskUid 為準。接著寫 6 條書:
curl -X POST http://localhost:7700/indexes/books_rank/documents \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  --data-binary '[
    {"id": 1, "title": "三体", "title_en": "The Three-Body Problem", "author": "刘慈欣", "genres": ["科幻"], "rating": 9.3, "summary": "three civilizations collide across light years"},
    {"id": 2, "title": "黑暗森林", "title_en": "The Dark Forest", "author": "刘慈欣", "genres": ["科幻"], "rating": 9.2, "summary": "civilizations hide from silent hunters"},
    {"id": 3, "title": "球状闪电", "title_en": "Ball Lightning", "author": "刘慈欣", "genres": ["科幻"], "rating": 8.8, "summary": "a quantum ghost of lightning research"},
    {"id": 4, "title": "活着", "title_en": "To Live", "author": "余华", "genres": ["文学"], "rating": 9.1, "summary": "one man survives decades of hardship"},
    {"id": 5, "title": "万历十五年", "title_en": "1587, a Year of No Significance", "author": "黄仁宇", "genres": ["历史"], "rating": 8.9, "summary": "a quiet year that shaped the dynasty"},
    {"id": 6, "title": "影之森", "title_en": "The Forest of Shadows", "author": "夏绿", "genres": ["悬疑"], "rating": 8.5, "summary": "dark secrets buried under a quiet canopy"}
  ]'
{
"taskUid": 1,
"indexUid": "books_rank",
"status": "enqueued",
"type": "documentAdditionOrUpdate"
}任務 succeeded 後,把本篇真正的主角請出來——預設排名規則名單:
curl http://localhost:7700/indexes/books_rank/settings/ranking-rules \
-H "Authorization: Bearer aSampleMasterKey"["words", "typo", "proximity", "attributeRank", "sort", "wordPosition", "exactness"]這就是預設 7 條。驗證兩條:GET /indexes/books_rank/stats 返回 numberOfDocuments: 6;上面這條 GET 返回 7 條規則的完整名單。少一條或者看到 attribute 而不是 attributeRank/wordPosition,都是版本問題,回第一步。等任務的方法忘了的話,見Meilisearch 添加文檔後立即搜索返回空結果。
先記住名單順序的含義:引擎按這個順序逐條裁決,排在前面的規則先說話,前面的規則分不出勝負才輪到後面的。這個「逐條裁決」的機制叫桶排序(bucket sort)——想像 7 個連續的篩子,全部文檔先過第一個篩子,沒分出勝負的再進第二個,一路篩到第七個。
第三步:第一次讀分數——讓排名開口說話
規則名單有了,但「words 排第一」是抽象的。這一步是全文的樞紐:發一個帶 showRankingScore 和 showRankingScoreDetails 的搜索請求,把排序過程變成能讀的數字。前者給每個結果一個 0.0 到 1.0 的總分(_rankingScore,1.0 是完美匹配),後者把總分拆成每條規則的小票(_rankingScoreDetails,每條規則的裁決明細)。
查詢用 dark forest:dark 在《黑暗森林》的 title_en 和《影之森》的 summary 裡,forest 在兩本書的 title_en 裡——所以《黑暗森林》兩個詞全中,《影之森》也兩個詞全中。先看這個全中的版本,下一步再製造分檔:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"dark forest","showRankingScore":true,"showRankingScoreDetails":true}'
《黑暗森林》那條結果的分數部分長這樣(完整返回體還有文檔字段和另一條結果):
{
  "title": "黑暗森林",
  "_rankingScore": 0.95,
  "_rankingScoreDetails": {
    "words": { "order": 0, "matchingWords": 2, "maxMatchingWords": 2, "score": 1 },
    "typo": { "order": 1, "typoCount": 0, "maxTypoCount": 2, "score": 1 },
    "proximity": { "order": 2, "score": 0.98 },
    "attributeRank": { "order": 3, "score": 1, "attributeRankingOrderScore": 1 },
    "wordPosition": { "order": 5, "score": 0.87 },
    "exactness": { "order": 6, "matchType": "noExactMatch", "score": 0.67 }
  }
}(_rankingScore 和各 score 的具體數值依賴數據與環境,以本地實測為準;鍵的名單也可能因規則是否參與裁決而略有出入——比如請求不帶 sort 參數時,小票裡就沒有 sort 鍵,讀懂結構就行。)
逐張讀小票——order 是這條規則在鏈裡的位置(從 0 起),score 是這條規則給這個文檔打的分(0 到 1):
words:matchingWords: 2, maxMatchingWords: 2——查詢 2 個詞命中 2 個,滿分。這是第一裁決規則,兩本書都 2/2,打平。typo:typoCount: 0——零錯字命中,又平。proximity:詞距分。dark和forest在《黑暗森林》的標題裡緊挨著,分高;《影之森》的dark在摘要、forest在標題,跨字段的詞距差一些,分低——這條是兩本書分出勝負的地方。attributeRank:字段權重分,看命中的詞落在多重要的字段。兩本書最好的命中都在title_en,這條打平;字段的權重序(attribute ranking order)預設按字段在文檔裡出現的先後生成,本例是id → title → title_en → author → genres → rating → summary。wordPosition:詞在字段內的位置分,越靠前越高。exactness:matchType: noExactMatch——查詢詞沒有精確等於任何字段的完整值。它有三檔:exactMatch(查詢恰好等於字段整個值)、matchesStart(匹配字段值開頭)、noExactMatch,第六步會親手做出前兩檔。
回頭看總分:_rankingScore: 0.95 不是 7 個分數的平均,而是靠前的規則權重遠大於靠後的——words 打平就不說了,proximity 一分高下,後面的 exactness 0.67 只在總分的零頭上。這就是為什麼兩條分數只差 0.0x 時,你該去 details 裡找是哪條規則的小票不一樣。驗證:同一請求的返回裡,《影之森》的 _rankingScore 低於《黑暗森林》,且 proximity 的 score 更低——能對上,說明你會讀了。
第四步:words 規則——命中幾個詞就是第一道門檻
上一步兩本書都是 2/2 全中,words 沒機會表演分檔。這一步換查詢製造分檔,順帶看 words 的兩個隱藏行為。查詢換成 dark shadows:shadows 只在《影之森》的 title_en 裡——於是《影之森》2/2,《黑暗森林》只有 dark 命中、1/2:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"dark shadows","showRankingScore":true,"showRankingScoreDetails":true}'
hits 顺序:影之森(2/2,_rankingScore 高)→ 黑暗森林(1/2,_rankingScore 低)
影之森 words 小票:matchingWords: 2, maxMatchingWords: 2, score: 1
黑暗森林 words 小票:matchingWords: 1, maxMatchingWords: 2, score: 0.5命中 2/2 的文檔永遠排在 1/2 前面——哪怕 1/2 那本評分 9.2、零錯字,2/2 那本評分 8.5。這就是桶排序的詞典序:規則之間沒有互補,第一條規則分出勝負,後面全部規則直接免賽。一個 2/2 但錯字多的文檔,穩壓一個 1/2 但零錯字的文檔。
words 還有兩個細節。第一,它處理查詢串是從右往左的:搜 batman dark knight 時,全中三詞的文檔最優先,只含 batman 的文檔最後才輪到——右邊的詞被「保」得更緊。第二,你的查詢最後一個詞自動按前綴處理:搜 fore 也能命中所有含 forest 的文檔(試一下就知道),這是搜索框邊打邊搜的體驗來源。這兩點官方排名規則文檔都有明說,日常調查詢詞序時用得上。
驗證:上面的請求裡,《黑暗森林》的 words 小票是 matchingWords: 1 且它排在《影之森》後面——能對上,words 的分檔邏輯你就拿下了。
第五步:typo 與 proximity——容錯不是放水,詞距不是玄學
前面幾步全是零錯字命中,這一步看兩條「打磨質量」的規則。先看 typo(容錯):查詢拼錯一個字母——forezt:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"forezt","showRankingScore":true,"showRankingScoreDetails":true}'
hits 顺序:影之森 → 黑暗森林(与 q=forest 完全一致)
两本书 typo 小票:typoCount: 1, maxTypoCount: 1(forest → forezt,一个错字)
两本书 _rankingScore 比零错字的 q=forest 明显更低兩件事值得看。第一,拼錯照樣有結果——Meilisearch 的容錯預設開著(1 個錯字對 ≥5 字符的詞生效;darc 這種 4 字符短詞不給容錯,直接搜不到,這是很多「為什麼搜不到」的真兇)。第二,typo 是排序規則:兩本書的 typoCount 都是 1,打平,所以順序由後面的 wordPosition 裁決,和零錯字的 q=forest 一模一樣;但分數掉了。想看「0 錯字穩壓 1 錯字」的現場,往 books_rank 再 POST 一條 title_en 裡真寫著 forezt 的新文檔就行——0 錯字的那本會壓過 1 錯字的,原理同第四步的 words 分檔。容錯閾值怎麼調、哪些詞定向關閉,拼寫容錯篇有完整操作。
再看 proximity(詞距)。查詢詞一樣,順序不同,詞距分不同——《影之森》的 title_en 是 The Forest of Shadows,forest 和 shadows 中間隔一個 of。對比兩個查詢:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"forest shadows","showRankingScore":true}'
curl -X POST http://localhost:7700/indexes/books_rank/search \
-H "Authorization: Bearer aSampleMasterKey" \
-H "Content-Type: application/json" \
-d '{"q":"shadows forest","showRankingScore":true}'q=forest shadows:影之森的 proximity 分更高,_rankingScore 更高
q=shadows forest:同一本书,词序颠倒,proximity 分下降,_rankingScore 跟着掉詞序和查詢一致的文檔優先——「dark knight」按序命中好過「knight …… dark」隔十詞命中。兩個請求裡《影之森》都排第一(它 2/2,words 先分出勝負),變的是它自己的分數——對照兩次響應裡的 _rankingScore 就能看到 proximity 的手筆。
驗證:forezt 的響應裡 typo 小票是 typoCount: 1;兩個詞序查詢的 _rankingScore 不相等——都對上,這兩條規則你就見過了。
第六步:attributeRank、wordPosition、exactness——剩餘三條各給一個現場
還剩三條規則,每條一個最小現場。先看 attributeRank(字段權重):同一個詞 dark,《黑暗森林》命中在 title_en,《影之森》命中在 summary——正好踩進兩個字段:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"dark","showRankingScore":true,"showRankingScoreDetails":true}'
hits 顺序:黑暗森林(dark 命中 title_en)→ 影之森(dark 命中 summary)有意思的地方在《影之森》那邊:它的 dark 是 summary 的第一個詞,詞位第 1;而《黑暗森林》的 dark 在 title_en 的第三個詞位。要是 wordPosition 先裁決,《影之森》該贏——但 attributeRank 在鏈上排第 4(order 3)、wordPosition 排第 6(order 5),字段權重先於詞位說話,命中重要字段的文檔贏。這正是 v1.36 把 attribute 拆成兩條的價值:拆開後你才能在「字段權重」和「詞位」之間插進 sort 或自定義規則,老版一條 attribute 管兩件事就沒這個操作空間(注意 attribute 不能和 attributeRank/wordPosition 同時出現在規則裡,混用會報錯)。
再給 wordPosition(詞位)一個獨立現場。查詢 forest:兩本書的 title_en 都含它——《影之森》The Forest of Shadows 裡在第 2 個詞位,《黑暗森林》The Dark Forest 裡在第 3 個詞位:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"forest","showRankingScore":true,"showRankingScoreDetails":true}'
hits 顺序:影之森(forest 在第 2 词位)→ 黑暗森林(forest 在第 3 词位)
两本书 attributeRank 小票完全相同(都命中 title_en)——打平后轮到 wordPosition 裁决《影之森》評分 8.5 反排在評分 9.2 的《黑暗森林》前面,原因就是詞位靠前。和上一步合起來看:dark 查詢裡 attributeRank 贏了詞位佔優的《影之森》,forest 查詢裡字段權重打平、詞位接手——兩條規則各管各的維度,誰先誰後由鏈上位置定。
最後 exactness(精確度)。查詢恰好等於字段完整值時觸發最高檔——用《萬曆十五年》:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"ball lightning","showRankingScoreDetails":true}'
球状闪电 exactness 小票:matchType: "exactMatch"(查询等于 title_en 整个值 "Ball Lightning")把查詢縮成 ball,同一本書的 matchType 變成 matchesStart(查詢精確匹配字段值的開頭);而前面幾步的 dark forest 們都是 noExactMatch。三檔就是這意思:整值匹配 > 開頭匹配 > 部分匹配,exactness 按檔排序。
驗證:dark 查詢裡《黑暗森林》在前、forest 查詢裡《影之森》在前、ball lightning 的 matchType 是 exactMatch——三個都對上,剩下 6 條規則的現場你就全部過完了(sort 那條只在請求帶 sort 參數時出場,用法歸排序與自定義排名篇,它不影響 _rankingScore)。
第七步:rankingScoreThreshold——把低分檔整檔切掉
讀得懂分數,就能用分數控結果。rankingScoreThreshold(0.0 到 1.0)給搜索加一條質量線:低於閾值的文檔全部不要。查詢回到 dark shadows——第四步裡它是 2/2 與 1/2 的分檔現場,現在把線畫在兩檔之間:
curl -X POST http://localhost:7700/indexes/books_rank/search \
  -H "Authorization: Bearer aSampleMasterKey" \
  -H "Content-Type: application/json" \
  -d '{"q":"dark shadows","showRankingScore":true,"rankingScoreThreshold":0.5}'
无阈值:hits = 影之森(2/2)→ 黑暗森林(1/2),estimatedTotalHits: 2
加阈值 0.5:hits = 影之森(2/2),estimatedTotalHits: 1——1/2 档整档消失閾值取值別拍腦袋,先用第三步的 showRankingScore 看你的數據在典型查詢下的分數分佈,把線畫在「好結果檔」和「差結果檔」的分界上。這裡有個反直覺的坑:被切掉的文檔不計入 estimatedTotalHits(估算的總命中數),也不計入 facet 分佈(facetDistribution,按可篩選字段統計的命中分佈,比如每個分類各命中幾本)——計數變小於不是索引丟數據,是引擎在第一個低於閾值的文檔處停止了掃描(結果按分數降序,後面只會更低,不必再掃)。想親手看 facet 的變化,得先補兩步前置:把 genres 加進 filterableAttributes(官方要求,能做 facet 的字段必須事先聲明,預設為空),再在請求裡帶 "facets":["genres"] 參數。這直接引出兩個結論:給前端展示「約 N 條結果」時要麼接受這個口徑、要麼另發一次不帶閾值的請求拿全量數字;rankingScoreThreshold 和 page/hitsPerPage 一起用會變慢——精確分頁要求掃完全部命中,停掃優化就沒了。哪個數字少了、分面選項不見了,先懷疑閾值,見Meilisearch rankingScoreThreshold 讓 estimatedTotalHits 驟降。
驗證:同一查詢去掉 rankingScoreThreshold 再發一次,estimatedTotalHits 回到 2——能對上,「讀分數 → 畫閾值 → 驗計數」這條鏈你就跑通了。
核心概念
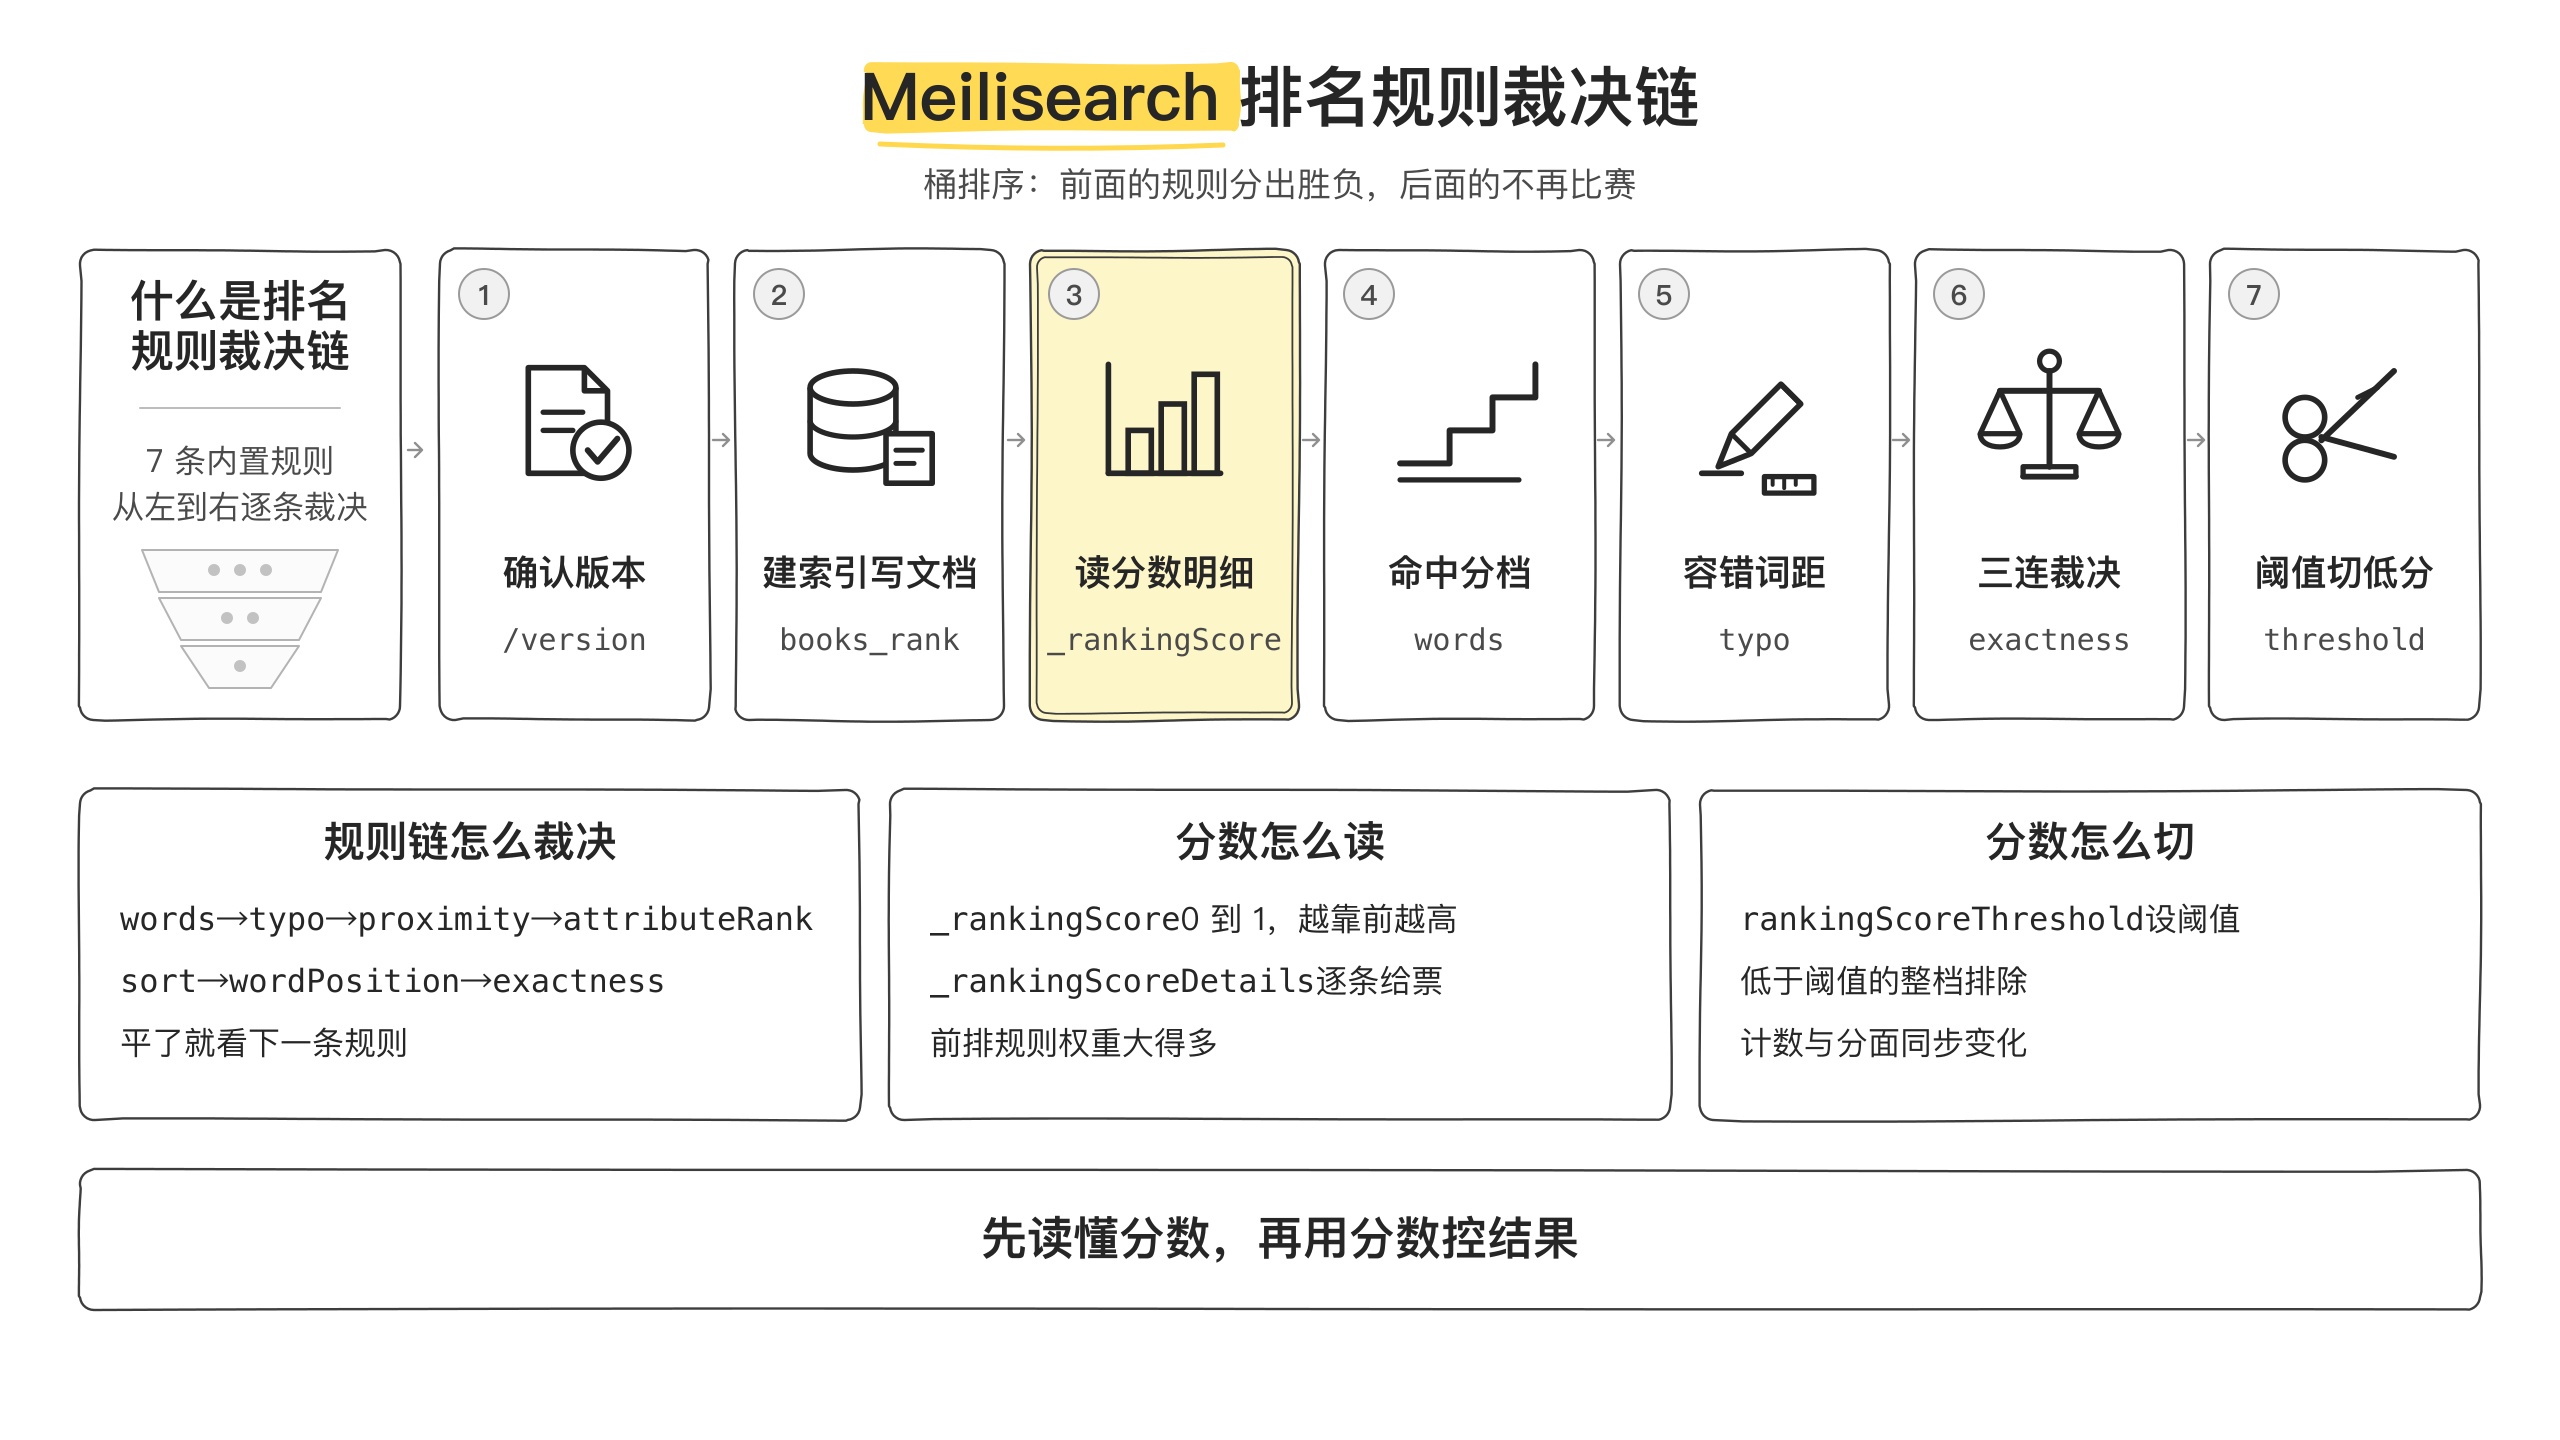
下面這張圖是 7 條規則的裁決走向:全部文檔從 words 進桶,逐條規則收窄,每條規則只處理前面全部打平的文檔。
| 概念 | 是什麼 | 類比 |
|---|---|---|
| rankingRules(排名規則鏈) | 7 條內置規則按序逐條裁決,排前面的先說話,打平才看下一條 | 像比賽評分:先比金牌數,同金再比銀牌,一路比到第 7 項 |
| 桶排序(bucket sort) | 每條規則把打平的文檔分進同一桶,只對桶內繼續下一條規則 | 像淘米:每遍篩子只處理上一遍留在篩面上的 |
_rankingScore |
每個結果的 0–1 總分,1.0 為完美匹配,靠前規則權重遠大於靠後 | 像高考總分:主科權重壓倒副科,副科只在主科同分時改變名次 |
_rankingScoreDetails |
每條規則的小票:order(位置)+ score(該規則給的分)+ 規則專屬字段 | 像購物小票分項:總價對不上時逐行對 |
attributeRank vs wordPosition |
前者只管命中字段多重要,後者只管詞在字段裡多靠前,v1.36 起拆開 | 像面試的「學歷關」和「氣場關」:拆開才能單獨調整出場順序 |
rankingScoreThreshold |
搜索的質量線,第一個低於閾值的文檔處停掃,其後全部排除 | 像錄取分數線:線下的檔案不看,統計口徑只算線上的 |
| matchingStrategy(隱式背景) | 查詢詞沒全中時引擎怎麼放鬆匹配,預設從末詞逐詞放鬆 | 像找人的時候先要全名,找不到再退一步只要姓 |
要點回顧
- 詞典序沒有互補——words 滿分但多錯字的文檔,穩壓 words 少命中但零錯字的文檔;規則之間不折衷,第一條分出勝負後面免賽。
- 小票讀數定位差異——兩條結果只差 0.0x 時,
_rankingScoreDetails裡逐條對score,第一個不一樣的鍵就是裁決規則。 - attributeRank 先於 wordPosition——字段權重(第 4 位)先於詞位(第 6 位)裁決,v1.36 拆開後才能在兩者之間插規則。
- 容錯不是放水——拼錯照樣命中但分數掉檔;1 個錯字對 ≥5 字符的詞生效,
darc這類 4 字符短詞沒有容錯空間。 - 閾值是停掃不是過濾——
rankingScoreThreshold之後的文檔不計入estimatedTotalHits與 facet 分佈,計數驟降先查閾值。
常見問題
PUT ranking-rules 後結果順序與相關度脫鉤(不報錯)
現象:PUT /settings/ranking-rules 只傳了自定義規則(如 ["rating:desc"]),任務 succeeded 不報錯,但拼錯詞的文檔和拼寫正確的平起平坐、命中標題的不再比命中摘要的靠前。
原因:PUT 是全量覆蓋語義,預設 7 條被沖掉,只剩 words 隱式兜底;typo、proximity、attributeRank、wordPosition、exactness 全部退場。
加了 rankingScoreThreshold 後計數和分面驟降
現象:estimatedTotalHits 從 2 變 1,facetDistribution 裡某選項整個消失,以為索引丟數據或 filter 失效。
原因:閾值是停掃語義——第一個低於閾值的文檔之後全部排除,且不計入計數與分面分布,不是數據丟了。
相關文章:Meilisearch rankingScoreThreshold 讓 estimatedTotalHits 驟降
invalid_settings_ranking_rules:設排名規則返回 400
現象:PUT /settings/ranking-rules 傳 ["words",...,"desc(release_date)"] 返回 400,錯誤碼 invalid_settings_ranking_rules。
原因:用了舊版函數式語法 asc()/desc(),自 v0.22 起廢棄。現行寫法是 属性:asc / 属性:desc,如 "release_date:desc"。